L’équipe Qwen d’Alibaba a lancé Qwen4-Max le 16 novembre 2026 en le présentant comme « votre nouveau coéquipier IA ». C’est un modèle de 2 400 milliards de paramètres, doté d’une fenêtre de contexte d’un million de tokens et d’une vision native, et il coûte moins cher que le modèle qu’il remplace. Il s’est hissé en une de Hacker News en quelques heures.
À retenir
- Alibaba a lancé Qwen4-Max le 16 novembre 2026 : 2,4T de paramètres, 71B actifs par token, vision native et contexte d’un million de tokens.
- Ses poids ne sont pas ouverts ; on l’utilise via l’API de QwenCloud ou le Token Plan, et dans des applications comme QwenStudio.
- Le prix catalogue est de 1,50 $ par million de tokens en entrée et 4,50 $ par million de tokens en sortie, soit 25 % de moins que Qwen3.8-Max.
- Artificial Analysis lui attribue 43 à son Intelligence Index, au-dessus de la médiane de 41 mais pas au niveau des meilleurs.
Ce guide présente ce qui a été lancé, quels chiffres du lancement viennent d’Alibaba et lesquels d’un benchmark indépendant, ce que coûte le modèle et comment lui envoyer votre première requête. Toutes les informations sont à jour au 16 novembre 2026.
Ce qu’Alibaba a réellement lancé
Qwen4-Max est le premier modèle de la famille Qwen4, et l’annonce officielle le décrit comme un modèle pour « le travail, la créativité et la découverte ». L’accent est mis sur les tâches longues plutôt que sur la conversation. Parmi les exemples d’Alibaba : la création de scènes 3D dans Blender, de jeux jouables dans Unity, Unreal Engine et Godot, un audit juridique portant sur 198 documents de travail et une exécution d’agent de 48 heures qui a conçu une nouvelle molécule de liquide de refroidissement.
Trois points comptent davantage que les démos :
- Ses poids ne sont pas ouverts. Qwen4-Max n’est disponible que via les applications et l’API d’Alibaba. Artificial Analysis le classe parmi les modèles propriétaires. Alibaba indique que des modèles Qwen4 plus petits « arrivent en open source », sans donner de date.
- Il est disponible dès maintenant. Selon l’annonce, le modèle est en ligne sur QwenCloud via le Token Plan ou l’API, ainsi que dans QwenWork, Qoder et QwenStudio.
- Il est livré avec une fonction d’agent baptisée Live Delivery. Sur les tâches longues, l’agent remet tôt une première version fonctionnelle et continue de l’améliorer, ce qui vous permet de le corriger en cours de route. Alibaba publie en open source un Qwen-Live-Delivery-Plugin pour l’accompagner.
Si vous avez utilisé des modèles Qwen précédents via des outils comme Qwen Code, Qwen4-Max est le nouveau haut de gamme de cette série.
Le saviez-vous ?
Dans une démo d’Alibaba, Qwen4 a travaillé seul pendant 48 heures et a conçu une nouvelle molécule de liquide de refroidissement pour les puces de centres de données, qu’un laboratoire a ensuite synthétisée.
Sous le capot
Selon Alibaba, Qwen4-Max est un modèle clairsemé à mélange d’experts (MoE). Seule une partie du réseau s’active pour chaque token :
- 2 400 milliards de paramètres dans le réseau principal, dont 71 milliards actifs par token.
- 328 milliards de paramètres supplémentaires de « N-gram Embedding », qui retrouvent à moindre coût des motifs locaux de tokens courants.
- Une nouvelle architecture d’attention. Les couches Gated DeltaNet compressent l’ancien contexte en états de taille fixe, et Qwen Sparse Attention ne retient que les blocs pertinents d’une longue entrée. C’est ce qui rend abordable une fenêtre d’un million de tokens.
- Des connexions « Gated Residual », auxquelles l’équipe attribue un entraînement « sans pics de perte ».
Alibaba affirme aussi que le modèle de base obtient des résultats de 5 à 13 % supérieurs à Qwen3.8-Max-Base dans ses tests internes, tout en activant 25 % de paramètres en moins. Ce sont des mesures maison que personne en dehors d’Alibaba n’a vérifiées.

Les chiffres revendiqués par Alibaba
L’annonce s’appuie sur Work360, un benchmark conçu par Alibaba elle-même. Il couvre 26 grands domaines professionnels et 721 spécialités. Voici ce qu’Alibaba rapporte :
| Affirmation (chiffres d’Alibaba) | Qwen3.8-Max | Qwen4-Max |
|---|---|---|
| Score Work360 | 47.74 | 52.69 |
| Coût moyen par tâche Work360 | $4.43 | $1.67 |
| Taux de réussite en code sécurisé (niveau fonction) | 22.0% | 31.8% |
Le chiffre phare, c’est le coût : une baisse de 62 % par tâche. Deux facteurs l’expliquent. Le nouveau modèle consomme moins de tokens pour le même travail (environ 24 à 35 % de moins sur Work360 et 48 à 49 % de moins sur Terminal-Bench 4.0, selon le niveau d’effort), et le prix par token est plus bas.
Prenez ces chiffres avec prudence. Work360 est le propre test d’Alibaba, les comparaisons se font avec son propre modèle précédent, et les études de cas sectorielles, comme la programmation d’une pièce ramenée de 475 minutes à 24, proviennent de déploiements chez des partenaires qu’Alibaba a choisi de mettre en avant.
Ce que dit un benchmark externe
Artificial Analysis soumet chaque modèle qu’il référence aux mêmes neuf évaluations. Ses premiers résultats pour Qwen4-Max dressent un tableau plus modeste :
- Intelligence Index : 43, 38e sur 81 modèles. La médiane des modèles comparables est de 41 : Qwen4-Max est donc au-dessus de la moyenne, mais pas parmi les meilleurs.
- Bavard : il a produit 127M de tokens en sortie sur l’ensemble de l’index, contre une médiane de 78,6M. Concrètement, il écrit davantage à chaque réponse.
- Coût d’exécution de l’index : 3,27 $ par tâche en moyenne.
- Il accepte du texte et des images en entrée, produit du texte et affiche une fenêtre de contexte de 984k tokens.
Pour la plupart des gens, c’est l’enseignement utile. Qwen4-Max est un modèle compétent et bien placé en prix pour les longues tâches d’agent, mais ce benchmark ne le place pas devant les meilleurs modèles occidentaux.
Le saviez-vous ?
Qwen4-Max a produit 127M de tokens en sortie sur l’index d’Artificial Analysis, contre une médiane de 78,6M : il a tendance à écrire de longues réponses.
Combien ça coûte
La page de tarifs de Model Studio affiche qwen4-max sur le déploiement international (Singapour) à :
- 1,50 $ par million de tokens en entrée
- 4,50 $ par million de tokens en sortie
- Un tarif unique pour les modes avec et sans raisonnement, pour toute requête jusqu’à 1M de tokens
- Un quota gratuit de 1 million de tokens, valable 90 jours
Qwen3.8-Max figure sur la même page à 2 $ en entrée et 6 $ en sortie : le nouveau modèle coûte donc 25 % de moins dans les deux cas. Alibaba dit aussi avoir appliqué des « baisses particulièrement importantes » au prix des entrées mises en cache, et Artificial Analysis indique une remise de 95 % sur le cache.
Pour une comparaison avec un modèle phare occidental, consultez notre guide de démarrage rapide de l’API GPT-6.1 Sol, qui détaille les prix d’OpenAI.
En chiffres
1,50 $par million de tokens en entrée
4,50 $par million de tokens en sortie
62 %de coût en moins par tâche (Alibaba)
Comment essayer Qwen4-Max
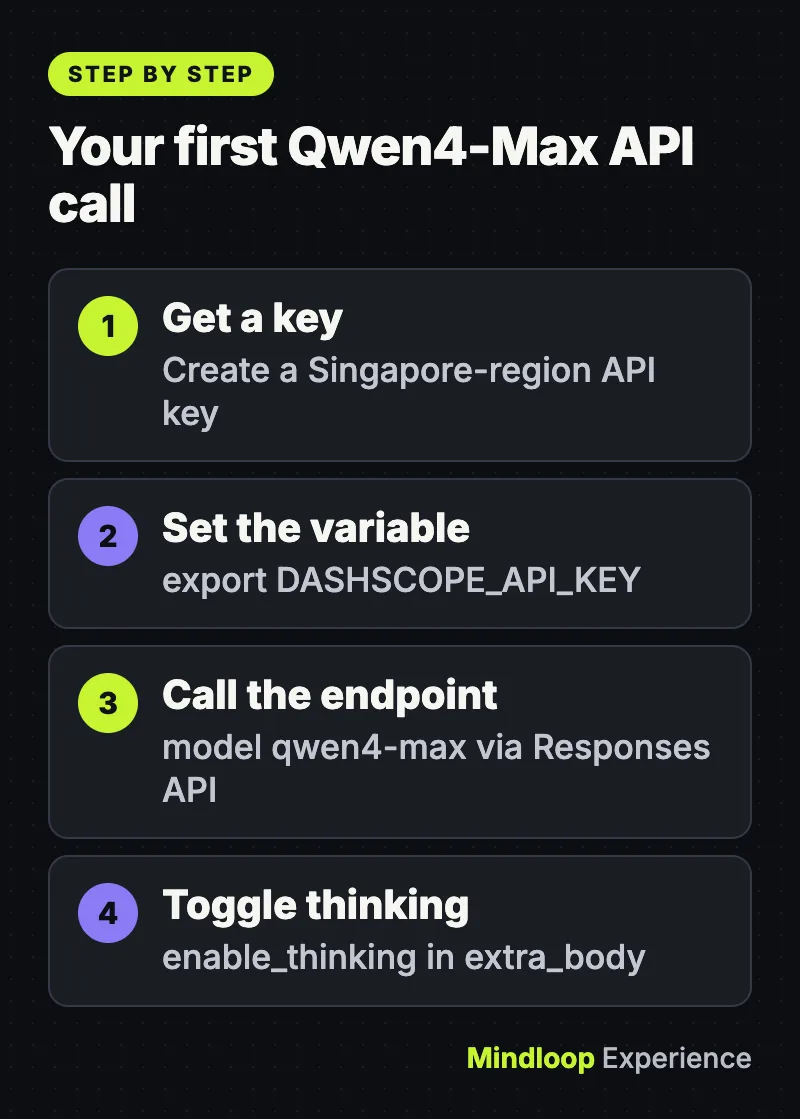
Ce qu’il vous faut : un compte Alibaba Cloud avec Model Studio activé, une clé API, l’identifiant de votre espace de travail et, pour passer par le SDK, Python avec le paquet openai installé (pip install openai).
- Essayez-le sans code. L’annonce renvoie vers QwenStudio et les applications d’Alibaba. C’est le moyen le plus rapide de juger si le modèle convient à votre travail.
- Obtenez une clé API. Dans la console Model Studio, créez une clé API pour la région de Singapour. La documentation d’Alibaba précise que les clés API diffèrent selon la région. Stockez-la dans une variable d’environnement plutôt que dans votre code :
export DASHSCOPE_API_KEY="sk-your-key-here"- Envoyez une première requête avec curl. Le guide du premier appel API d’Alibaba utilise un endpoint Responses compatible OpenAI. Remplacez
{WorkspaceId}par l’identifiant de votre espace de travail :
curl "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/responses" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
-d '{ "model": "qwen4-max", "input": "Who are you?" }'- Utilisez le SDK Python d’OpenAI. L’endpoint étant compatible OpenAI, il suffit de changer l’URL de base et le nom du modèle :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
response = client.responses.create(model="qwen4-max", input="Who are you?")
print(response.output_text)- Activez ou désactivez le raisonnement. D’après la documentation sur le raisonnement approfondi, Qwen4-Max est un modèle hybride : on active le raisonnement requête par requête avec
enable_thinking. Ce n’est pas un paramètre standard d’OpenAI, il se place donc dansextra_body:
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=[{"role": "user", "content": "Plan a three-step database migration."}],
    extra_body={"enable_thinking": True},
    stream=True,
)
Laissez le raisonnement désactivé pour les recherches rapides et activez-le pour la planification, les maths et le code en plusieurs étapes. Avec le raisonnement activé, le modèle écrit davantage, et vous payez ces tokens.
Erreurs courantes et solutions
- Erreurs d’authentification : la clé et l’endpoint doivent appartenir à la même région. Une clé d’une autre région ne fonctionnera pas sur l’endpoint de Singapour.
- Les requêtes vers une URL contenant encore
{WorkspaceId}échouent : il faut remplacer ce marqueur par le véritable identifiant de votre espace de travail, visible dans la console. enable_thinkingprovoque une erreur dans le SDK : passez-le dansextra_body, et non comme argument nommé à part entière.- Factures plus élevées que prévu : Artificial Analysis a trouvé le modèle bavard. Fixez une longueur de sortie maximale et n’utilisez le raisonnement que là où il est utile.
Ce que cela change pour vous
- Si vous créez des agents : Qwen4-Max mérite un test sur des tâches longues et gourmandes en outils. Son prix est inférieur à celui de la plupart des modèles de pointe, et le cache le réduit encore. Essayez-le sur vos propres tâches avant de croire aux 62 %.
- Si vous devez faire tourner des modèles en local : celui-ci ne vous aidera pas, car ses poids ne sont pas publics. Pour l’instant, tournez-vous vers les modèles ouverts présentés dans notre guide pour faire tourner Qwen 3.8 en local avec llama.cpp, et guettez les modèles Qwen4 plus petits promis par Alibaba.
- Si vous ne faites que discuter : vous pouvez l’essayer dans les applications d’Alibaba, mais selon les benchmarks externes le modèle est au-dessus de la moyenne, sans être un net progrès par rapport à ce que vous utilisez déjà.
- Si vos données sont sensibles : il s’agit d’un modèle hébergé, exploité par Alibaba Cloud. Vérifiez où tourne l’endpoint de votre région et ce que votre entreprise autorise avant de lui envoyer des documents.
Retrouvez davantage d’articles sur les modèles derrière ces outils dans notre rubrique IA & technologie.
Questions fréquentes
Qwen4-Max est-il open source ?
Non. Qwen4-Max n’est disponible que via les applications et l’API d’Alibaba. Alibaba annonce des modèles Qwen4 plus petits en open source, sans date.
Combien coûte l’API Qwen4-Max ?
Sur le déploiement international (Singapour), elle coûte 1,50 $ par million de tokens en entrée et 4,50 $ par million de tokens en sortie, en mode avec ou sans raisonnement, avec un quota gratuit de 1 million de tokens valable 90 jours.
Qwen4-Max est-il meilleur que Qwen3.8-Max ?
Sur le benchmark Work360 d’Alibaba, il obtient 52,69 contre 47,74, et Alibaba affirme que le coût moyen par tâche est passé de 4,43 $ à 1,67 $. Ce sont les chiffres d’Alibaba ; vérifiez-les sur vos propres tâches.
Peut-on utiliser Qwen4-Max avec le SDK d’OpenAI ?
Oui. L’endpoint d’Alibaba est compatible OpenAI : définissez comme URL de base l’adresse compatible-mode de votre espace de travail, utilisez votre DASHSCOPE_API_KEY et indiquez le modèle qwen4-max.
Petit quiz
Combien de paramètres Qwen4-Max active-t-il par token ?
- 2 400 milliards
- 71 milliards
- 328 milliards
C’est un modèle clairsemé à mélange d’experts : 2,4T de paramètres dans le réseau principal, mais seuls 71B s’exécutent pour chaque token.
D’où vient la baisse de 62 % du coût par tâche ?
- Moins de tokens par tâche et des prix plus bas
- Une offre gratuite
- Des poids ouverts
Alibaba indique que le modèle consomme moins de tokens sur Work360 et que le prix par token a baissé.
Comment activer le raisonnement avec le SDK d’OpenAI ?
- En utilisant un autre nom de modèle
- En passant enable_thinking dans extra_body
- En ajoutant un prompt système
enable_thinking n’est pas un paramètre standard d’OpenAI : il se place donc dans extra_body.
Sources
- Qwen4-Max: Your New Teammate Has Arrived (Qwen team)
- Model Studio model pricing (Alibaba Cloud)
- Make your first API call to Qwen (Alibaba Cloud)
- Deep thinking models (Alibaba Cloud)
- Recommended models (Alibaba Cloud Model Studio)
- Qwen4 Max: Intelligence, Performance and Price Analysis (Artificial Analysis)



Écrire une réponse