El equipo Qwen de Alibaba lanzó Qwen4-Max el 16 de noviembre de 2026 y lo presentó como «tu nuevo compañero de equipo de IA». Es un modelo de 2,4 billones de parámetros con una ventana de contexto de un millón de tokens y visión nativa, y cuesta menos que el modelo al que sustituye. En pocas horas llegó a la portada de Hacker News.
Puntos clave
- Alibaba lanzó Qwen4-Max el 16 de noviembre de 2026: 2,4T de parámetros, 71B activos por token, visión nativa y un contexto de un millón de tokens.
- No tiene pesos abiertos; se usa a través de la API de QwenCloud o el Token Plan y de apps como QwenStudio.
- El precio de lista es de 1,50 $ por millón de tokens de entrada y 4,50 $ por millón de tokens de salida, un 25 % menos que Qwen3.8-Max.
- Artificial Analysis le da un 43 en su Intelligence Index, por encima de la mediana de 41 pero lejos de la vanguardia.
Esta guía explica qué se ha lanzado, qué cifras del lanzamiento vienen de Alibaba y cuáles de un benchmark independiente, cuánto cuesta el modelo y cómo enviarle tu primera petición. Todos los datos están actualizados a 16 de noviembre de 2026.
Qué ha lanzado realmente Alibaba
Qwen4-Max es el primer modelo de la familia Qwen4, y el anuncio oficial lo describe como un modelo para «el trabajo, la creatividad y el descubrimiento». El foco está en las tareas largas más que en el chat. Entre los ejemplos de Alibaba hay escenas 3D creadas en Blender, juegos jugables hechos en Unity, Unreal Engine y Godot, una revisión legal (due diligence) de 198 documentos de trabajo y una ejecución de un agente durante 48 horas que diseñó una nueva molécula refrigerante.
Hay tres puntos que importan más que las demos:
- No tiene pesos abiertos. Qwen4-Max solo está disponible a través de las apps y la API de Alibaba. Artificial Analysis lo clasifica como modelo propietario. Alibaba dice que los modelos Qwen4 más pequeños «llegarán como código abierto», pero no da fecha.
- Ya está disponible. El anuncio dice que el modelo está activo en QwenCloud mediante el Token Plan o la API, y también en QwenWork, Qoder y QwenStudio.
- Incluye una función de agente llamada Live Delivery. En tareas largas, el agente entrega pronto una primera versión que funciona y la sigue mejorando, así que puedes corregirlo a mitad de camino. Alibaba va a publicar como código abierto un Qwen-Live-Delivery-Plugin para acompañarla.
Si has usado modelos Qwen anteriores con herramientas como Qwen Code, Qwen4-Max es el nuevo tope de gama.
¿Sabías que…?
En una demo de Alibaba, Qwen4 trabajó solo durante 48 horas y diseñó una nueva molécula refrigerante para chips de centros de datos que luego un laboratorio sintetizó.
Qué hay bajo el capó
Según Alibaba, Qwen4-Max es un modelo disperso de mezcla de expertos (MoE). Solo una parte de la red se activa para cada token:
- 2,4 billones de parámetros en la red principal, de los cuales 71.000 millones están activos por token.
- Otros 328.000 millones de parámetros de «N-gram Embedding» que consultan de forma barata patrones locales de tokens habituales.
- Un nuevo diseño de atención. Las capas Gated DeltaNet comprimen el contexto antiguo en estados de tamaño fijo, y Qwen Sparse Attention selecciona solo los bloques relevantes de una entrada larga. Esto es lo que hace asequible una ventana de un millón de tokens.
- Conexiones «Gated Residual», a las que el equipo atribuye un entrenamiento «sin picos de pérdida».
Alibaba también afirma que el modelo base puntúa entre un 5 % y un 13 % mejor que Qwen3.8-Max-Base en sus pruebas internas, activando un 25 % menos de parámetros. Son mediciones internas que nadie fuera de Alibaba ha comprobado.

Las cifras que reivindica Alibaba
El anuncio se apoya en Work360, un benchmark creado por la propia Alibaba. Abarca 26 dominios de trabajo de primer nivel y 721 campos especializados. Esto es lo que informa Alibaba:
| Afirmación (cifras de la propia Alibaba) | Qwen3.8-Max | Qwen4-Max |
|---|---|---|
| Puntuación en Work360 | 47.74 | 52.69 |
| Coste medio por tarea de Work360 | $4.43 | $1.67 |
| Tasa de aprobación en código seguro (nivel de función) | 22.0% | 31.8% |
La cifra de coste es el titular: una bajada del 62 % por tarea. La explican dos cosas. El nuevo modelo usa menos tokens para el mismo trabajo (entre un 24 % y un 35 % menos en Work360 y entre un 48 % y un 49 % menos en Terminal-Bench 4.0, según el nivel de esfuerzo), y el precio por token es más bajo.
Toma estas cifras con cautela. Work360 es una prueba de la propia Alibaba, las comparaciones son con su propio modelo anterior, y los casos de estudio del sector, como reducir la programación de una pieza de 475 minutos a 24, vienen de despliegues de socios que Alibaba eligió mostrar.
Qué dice un benchmark externo
Artificial Analysis ejecuta las mismas nueve evaluaciones en cada modelo que incluye. Sus primeros resultados para Qwen4-Max dan una imagen más modesta:
- Intelligence Index: 43, en el puesto 38 de 81 modelos. La mediana de los modelos comparables es 41, así que Qwen4-Max está por encima de la media, pero no en la vanguardia.
- Verboso: generó 127M de tokens de salida en todo el índice, frente a una mediana de 78,6M. En la práctica, escribe más en cada respuesta.
- Coste de ejecutar el índice: 3,27 $ por tarea de media.
- Acepta texto e imágenes como entrada, genera texto y tiene una ventana de contexto declarada de 984k tokens.
Para la mayoría, esta es la conclusión útil. Qwen4-Max es un modelo competente y con buen precio para tareas largas de agentes, pero este benchmark no lo sitúa por delante de los mejores modelos occidentales.
¿Sabías que…?
Qwen4-Max generó 127M de tokens de salida en el índice de Artificial Analysis, frente a una mediana de 78,6M, así que tiende a dar respuestas largas.
Cuánto cuesta
La página de precios de Model Studio recoge qwen4-max en el despliegue internacional (Singapur) a:
- 1,50 $ por millón de tokens de entrada
- 4,50 $ por millón de tokens de salida
- Un único precio para el modo con y sin razonamiento, en cualquier petición de hasta 1M de tokens
- Una cuota gratuita de 1 millón de tokens, válida durante 90 días
Qwen3.8-Max aparece en la misma página a 2 $ de entrada y 6 $ de salida, así que el nuevo modelo cuesta un 25 % menos en ambos casos. Alibaba también dice que aplicó «rebajas especialmente grandes» al precio de la entrada en caché, y Artificial Analysis indica un descuento del 95 % por caché.
Para compararlo con un modelo insignia occidental, consulta nuestra guía rápida de la API de GPT-6.1 Sol, que repasa los precios de OpenAI.
En cifras
1,50 $por millón de tokens de entrada
4,50 $por millón de tokens de salida
62 %menos coste por tarea (Alibaba)
Cómo probar Qwen4-Max
Qué necesitas: una cuenta de Alibaba Cloud con Model Studio activado, una clave de API, el ID de tu espacio de trabajo y, para la vía del SDK, Python con el paquete openai instalado (pip install openai).
- Pruébalo sin código. El anuncio remite a QwenStudio y a las apps de Alibaba. Es la forma más rápida de saber si el modelo encaja con tu trabajo.
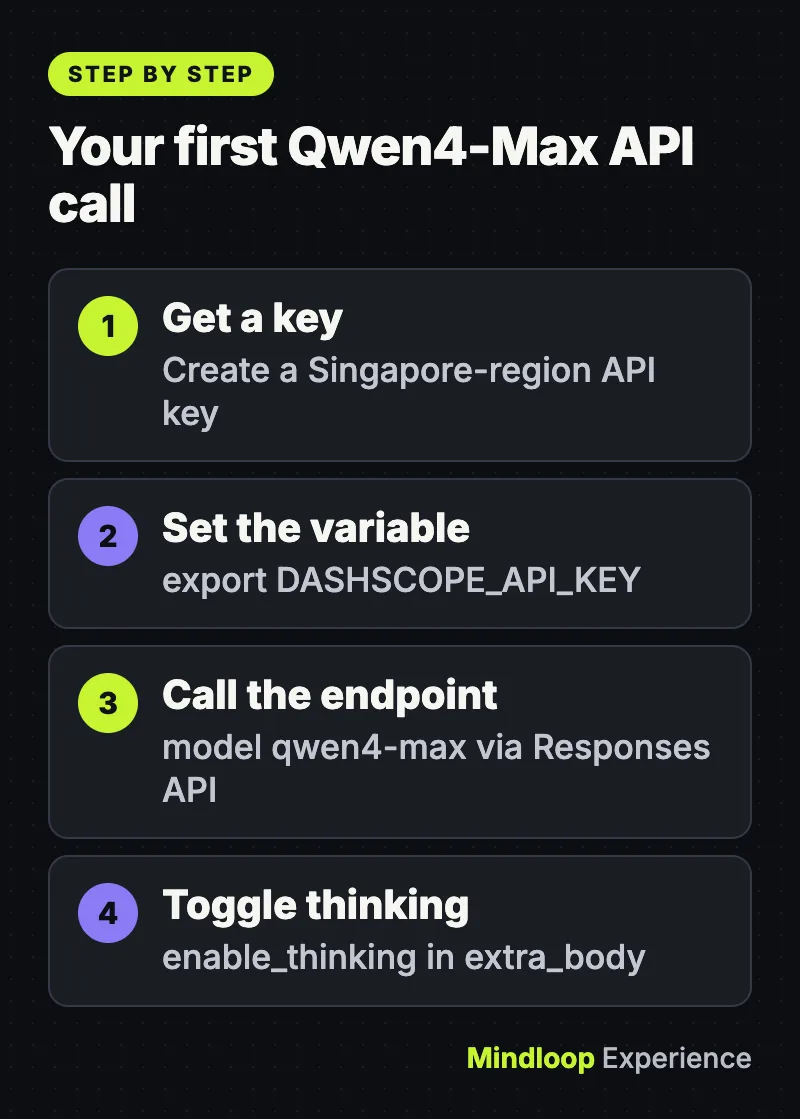
- Consigue una clave de API. En la consola de Model Studio, crea una clave de API para la región de Singapur. La documentación de Alibaba advierte que las claves de API son distintas en cada región. Guárdala como variable de entorno en lugar de ponerla en tu código:
export DASHSCOPE_API_KEY="sk-your-key-here"- Envía una primera petición con curl. La guía de la primera llamada a la API de Alibaba usa un endpoint Responses compatible con OpenAI. Sustituye
{WorkspaceId}por el ID de tu espacio de trabajo:
curl "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/responses" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
-d '{ "model": "qwen4-max", "input": "Who are you?" }'- Usa el SDK de Python de OpenAI. Como el endpoint es compatible con OpenAI, solo cambias la URL base y el nombre del modelo:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
response = client.responses.create(model="qwen4-max", input="Who are you?")
print(response.output_text)- Activa o desactiva el razonamiento. Según la documentación de razonamiento profundo, Qwen4-Max es un modelo híbrido: el razonamiento se activa en cada petición con
enable_thinking. No es un parámetro estándar de OpenAI, así que va enextra_body:
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=[{"role": "user", "content": "Plan a three-step database migration."}],
    extra_body={"enable_thinking": True},
    stream=True,
)
Deja el razonamiento desactivado para consultas rápidas y actívalo para planificación, matemáticas y código de varios pasos. Con el razonamiento activado, el modelo escribe más y pagas esos tokens.
Errores comunes y soluciones
- Errores de autenticación: la clave y el endpoint deben pertenecer a la misma región. Una clave de otra región no funcionará en el endpoint de Singapur.
- Fallan las peticiones a una URL que aún contiene
{WorkspaceId}: hay que sustituir el marcador por el ID real de tu espacio de trabajo, que encontrarás en la consola. enable_thinkingda error en el SDK: pásalo dentro deextra_body, no como argumento propio.- Facturas más altas de lo esperado: Artificial Analysis vio que el modelo es verboso. Fija una longitud máxima de salida y usa el razonamiento solo donde ayude.
Qué significa para ti
- Si creas agentes: merece la pena probar Qwen4-Max en tareas largas y con muchas herramientas. El precio está por debajo de la mayoría de los modelos punteros, y la caché lo reduce aún más. Pruébalo con tus propias tareas antes de fiarte de ese 62 %.
- Si necesitas ejecutar modelos en local: este no te sirve, porque los pesos no son públicos. Por ahora, echa un vistazo a los modelos abiertos de nuestra guía para ejecutar Qwen 3.8 en local con llama.cpp, y atento a los modelos Qwen4 más pequeños que ha prometido Alibaba.
- Si solo chateas: puedes probarlo en las apps de Alibaba, pero según los benchmarks externos el modelo está por encima de la media, no es una mejora clara respecto a lo que ya usas.
- Si tus datos son sensibles: es un modelo alojado que gestiona Alibaba Cloud. Comprueba dónde se ejecuta el endpoint de tu región y qué permite tu empresa antes de enviarle documentos.
Tienes más sobre los modelos que hay detrás de estas herramientas en nuestra sección de IA y tecnología.
Preguntas frecuentes
¿Qwen4-Max es de código abierto?
No. Qwen4-Max solo está disponible en las apps y la API de Alibaba. Alibaba dice que los modelos Qwen4 más pequeños llegarán como código abierto, sin fecha.
¿Cuánto cuesta la API de Qwen4-Max?
En el despliegue internacional (Singapur) cuesta 1,50 $ por millón de tokens de entrada y 4,50 $ por millón de tokens de salida, tanto en modo con razonamiento como sin él, con una cuota gratuita de 1 millón de tokens válida durante 90 días.
¿Qwen4-Max es mejor que Qwen3.8-Max?
En el benchmark Work360 de la propia Alibaba obtiene 52,69 frente a 47,74, y Alibaba dice que el coste medio por tarea bajó de 4,43 $ a 1,67 $. Son cifras de Alibaba; compruébalas con tus propias tareas.
¿Puedo usar Qwen4-Max con el SDK de OpenAI?
Sí. El endpoint de Alibaba es compatible con OpenAI: pon como URL base la dirección compatible-mode de tu espacio de trabajo, usa tu DASHSCOPE_API_KEY y define el modelo como qwen4-max.
Test rápido
¿Cuántos parámetros activa Qwen4-Max por token?
- 2,4 billones
- 71.000 millones
- 328.000 millones
Es un modelo disperso de mezcla de expertos: 2,4T de parámetros en la red principal, pero solo 71B se ejecutan para cada token.
¿De dónde sale el 62 % menos de coste por tarea?
- Menos tokens por tarea y precios más bajos
- Un plan gratuito
- Pesos abiertos
Alibaba dice que el modelo usa menos tokens en Work360 y que el precio por token ha bajado.
¿Cómo se activa el razonamiento con el SDK de OpenAI?
- Usando otro nombre de modelo
- Pasando enable_thinking en extra_body
- Añadiendo un prompt de sistema
enable_thinking no es un parámetro estándar de OpenAI, así que va en extra_body.
Fuentes
- Qwen4-Max: Your New Teammate Has Arrived (Qwen team)
- Model Studio model pricing (Alibaba Cloud)
- Make your first API call to Qwen (Alibaba Cloud)
- Deep thinking models (Alibaba Cloud)
- Recommended models (Alibaba Cloud Model Studio)
- Qwen4 Max: Intelligence, Performance and Price Analysis (Artificial Analysis)



Escribe una respuesta