Grok 4.7 es el modelo más nuevo y potente de la API de xAI, y puedes llamarlo desde una terminal o un script corto en pocos minutos. Esta guía te lleva paso a paso: crear una clave, enviar una primera solicitud con curl, Python y JavaScript y luego usar las funciones que querrás después: nivel de razonamiento, preguntas de seguimiento, búsqueda web en vivo, control de costos y las nuevas pautas de contenido. Los comandos siguen la documentación oficial en docs.x.ai, revisada el 15 de noviembre de 2026.
Puntos clave
- Grok 4.7 es el modelo más potente de la API de xAI, con una ventana de contexto de 500.000 tokens.
- Crea una clave en console.x.ai, guárdala como XAI_API_KEY y llama a la Responses API con curl o con el SDK de OpenAI.
- Ajusta el nivel de razonamiento de low a xhigh, continúa chats con previous_response_id y añade la herramienta web_search para obtener respuestas actuales.
- Cada respuesta indica su precio exacto en cost_in_usd_ticks, y las pautas opcionales rechazan nsfw, violence o profanity.
Una nota sobre el nombre: la documentación ahora llama a la empresa SpaceXSI, pero el servicio sigue siendo «the xAI API», la dirección sigue siendo api.x.ai y la variable de la clave sigue siendo XAI_API_KEY.
Qué necesitas
- Una cuenta en console.x.ai con créditos cargados. La guía de inicio rápido indica que cargues créditos antes de usar la API.
- Una terminal con
curl. Con eso basta para toda la guía. - Opcional: Python con
pip, o Node.js connpm, si quieres llamar a la API desde código.
Grok 4.7 de un vistazo
Estos datos provienen de la página de Grok 4.7 y de la página de precios a fecha del 15 de noviembre de 2026. Los precios cambian, así que revísalos antes de hacer un presupuesto.
| Característica | Valor |
|---|---|
| Nombre del modelo | grok-4.7 |
| Ventana de contexto | 500.000 tokens |
| Fecha de corte del conocimiento | Mayo de 2026 |
| Entrada | Texto e imágenes |
| Salida | Texto |
| Precio, prompts de menos de 200k tokens | 2,00 US$ de entrada, 0,50 US$ de entrada en caché, 6,00 US$ de salida por cada millón de tokens |
| Precio, prompts de 200k tokens o más | 4,00 US$ de entrada, 1,00 US$ de entrada en caché, 12,00 US$ de salida por cada millón de tokens |
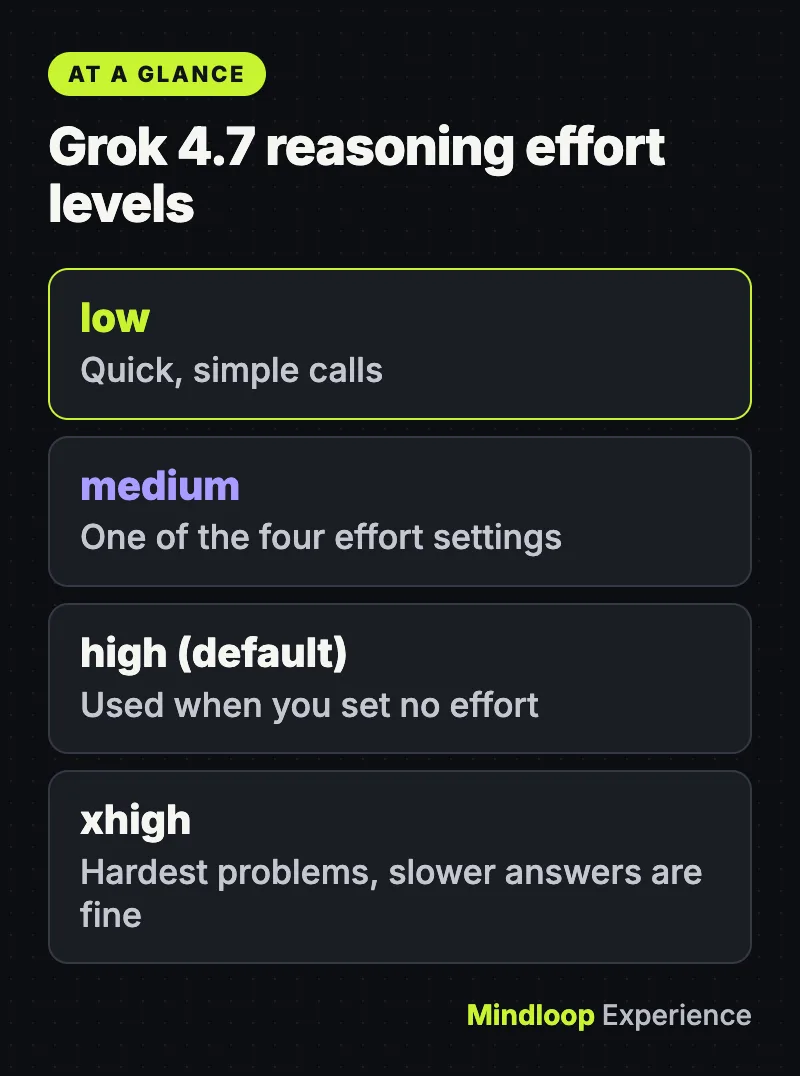
| Nivel de razonamiento | low, medium, high (predeterminado) o xhigh |
En cifras
500.000 tokensventana de contexto
2,00 US$de entrada por millón de tokens, menos de 200k
6,00 US$de salida por millón de tokens, menos de 200k
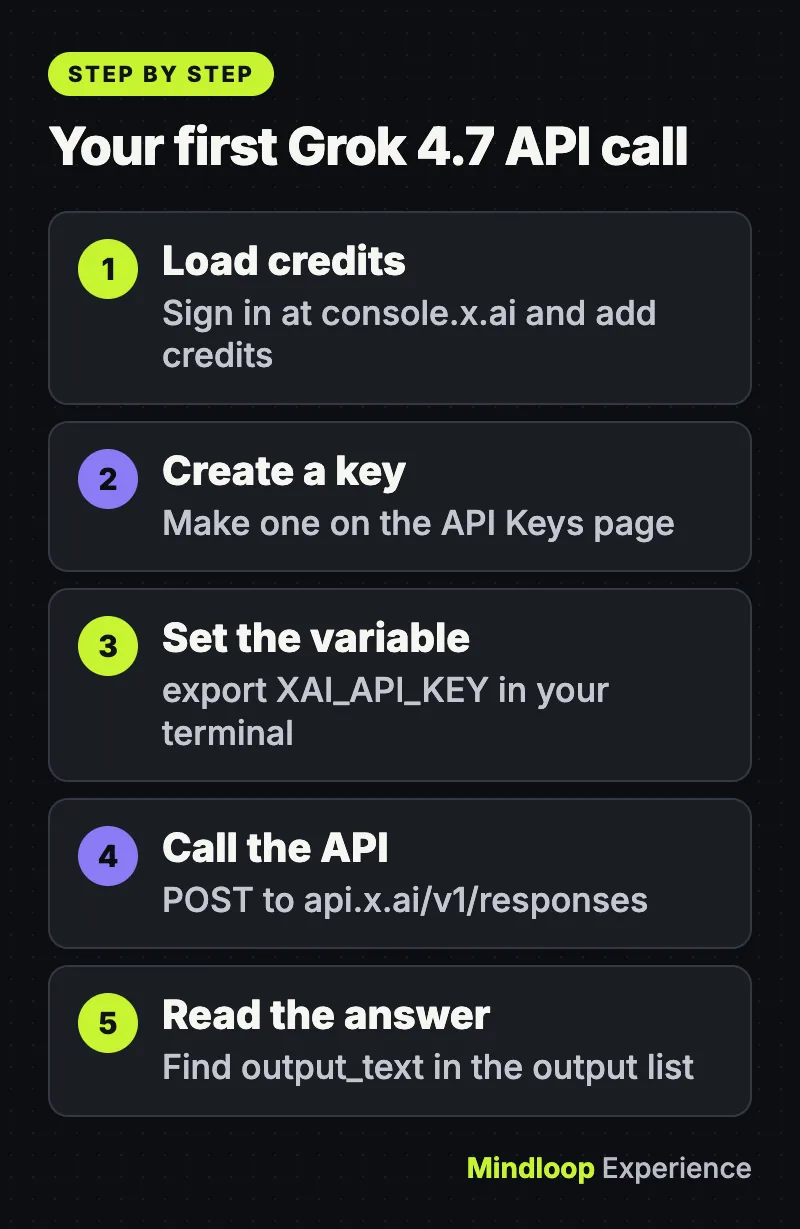
Paso 1: Crea una clave de API
- Inicia sesión en console.x.ai y añade créditos.
- Abre la página API Keys y crea una clave.
- Guárdala en una variable de entorno para que nunca quede en tu código:
export XAI_API_KEY="your_api_key"En Windows PowerShell, usa en su lugar $env:XAI_API_KEY="your_api_key". Trata la clave como una contraseña. No la pegues en documentos compartidos ni la subas a un repositorio.
Paso 2: Envía tu primera solicitud con curl
La documentación recomienda la Responses API, en https://api.x.ai/v1/responses. Este es el ejemplo de la guía de inicio rápido:
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.7",
    "input": "Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}"
  }'
Resultado esperado: un objeto JSON. La respuesta está dentro de la lista output, en un elemento de tipo message cuyo contenido es de tipo output_text. El mismo objeto tiene un id (lo usarás en el paso 5) y un bloque usage con el recuento de tokens.
Paso 3: Llámalo desde Python o JavaScript
La API funciona con los SDK de OpenAI si los apuntas a la URL base de xAI. Instala uno:
pip install openainpm install openaiPython:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("XAI_API_KEY"),
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.7",
    input="Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}",
)

print(response.output_text)
JavaScript (guárdalo como archivo .mjs para que import y await de nivel superior funcionen en Node.js):
import OpenAI from 'openai';

const client = new OpenAI({
  apiKey: process.env.XAI_API_KEY,
  baseURL: 'https://api.x.ai/v1',
});

const response = await client.responses.create({
  model: 'grok-4.7',
  input: 'Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}',
});

console.log(response.output_text);
Ambos imprimen solo el texto del modelo. xAI también tiene su propio paquete de Python (pip install xai-sdk), y la documentación dice que no hay problema en combinar los dos.
Paso 4: Elige cuánto piensa el modelo
Grok 4.7 siempre razona antes de responder. No puedes desactivarlo, pero la guía de razonamiento te permite fijar el esfuerzo. El valor predeterminado es high. Usa low para llamadas rápidas y sencillas y xhigh para los problemas más difíciles, cuando una respuesta más lenta es aceptable.
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -m 3600 \
  -d '{
    "model": "grok-4.7",
    "reasoning": {"effort": "low"},
    "input": "Summarise the difference between TCP and UDP in three bullet points."
  }'
La opción -m 3600 deja que la solicitud dure hasta una hora antes de que curl se rinda. La documentación la usa en sus ejemplos de razonamiento porque el razonamiento profundo puede tardar. En Python, el mismo ajuste es reasoning={"effort": "low"}.
Paso 5: Haz una pregunta de seguimiento sin reenviar el chat
Por defecto, la Responses API guarda cada intercambio en los servidores de xAI durante 30 días, según la guía de generación de texto. Así puedes continuar una conversación pasando el id de la respuesta anterior:
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -m 3600 \
  -d '{
    "model": "grok-4.7",
    "previous_response_id": "The previous response ID",
    "input": [
        {
            "role": "user",
            "content": "How do stars form?"
        }
    ]
}'
Sustituye el marcador por el id de tu respuesta anterior. Si prefieres que no se guarden las solicitudes, añade "store": false a la solicitud y guarda tú mismo el historial.
¿Sabías que…?
Por defecto, la Responses API guarda cada intercambio en los servidores de xAI durante 30 días. Añade «store»: false a una solicitud si prefieres guardar tú mismo el historial de la conversación.
Paso 6: Deja que Grok busque en la web
La página de modelos lo dice sin rodeos: sin herramientas de búsqueda, Grok no sabe nada más allá de sus datos de entrenamiento. Para obtener respuestas actuales, añade la herramienta de búsqueda web:
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
  "model": "grok-4.7",
  "input": [
    {
      "role": "user",
      "content": "What were the main technology headlines this week?"
    }
  ],
  "tools": [
    {
      "type": "web_search"
    }
  ]
}'
Grok decide cuántas búsquedas hace. A 15 de noviembre de 2026, la búsqueda web cuesta 5 US$ por cada 1.000 llamadas, además del cobro normal por tokens, así que un prompt con mucha investigación cuesta más que uno simple.
Paso 7: Mira cuánto costó cada solicitud
Cada respuesta indica su precio exacto en un campo llamado cost_in_usd_ticks, descrito en la guía de control de costos. Un dólar estadounidense equivale a 10.000.000.000 ticks. Si tienes jq instalado, esto muestra la cifra de una sola llamada:
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.7",
    "input": "Say hello"
  }' | jq '.usage.cost_in_usd_ticks'
Divide el resultado entre 10.000.000.000 para obtener dólares. El ejemplo de la propia documentación: 37756000 ticks son unos 0,0038 US$.
¿Sabías que…?
xAI cobra las solicitudes en ticks: un dólar estadounidense equivale a 10.000.000.000 ticks. El ejemplo de la documentación de 37756000 ticks sale a unos 0,0038 US$.
Paso 8 (opcional): Añade pautas de contenido
En octubre de 2026, xAI añadió controles de moderación personalizados. Adjuntas una lista guidelines a una solicitud y Grok rechaza ese tipo de contenido mientras escribe. Hay tres categorías, nsfw, violence y profanity, y el único comportamiento disponible hoy es decline.
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.7",
    "input": "Write a short story about a knight.",
    "guidelines": [
      { "type": "policy", "category": "violence", "behavior": "decline" },
      { "type": "policy", "category": "nsfw", "behavior": "decline" }
    ]
  }'
Las pautas solo se aplican a la solicitud que las incluye, así que envíalas cada vez. Con el SDK de OpenAI para Python, pasa la lista dentro de extra_body, porque ese SDK no tiene un parámetro guidelines propio.
Errores comunes y soluciones
Los códigos de estado de abajo provienen de la página de depuración de xAI y de las guías enlazadas arriba.
| Lo que ves | Causa probable | Solución |
|---|---|---|
401 Unauthorized | Falta el encabezado de autorización o la clave no es válida | Envía Authorization: Bearer <your key> y comprueba que la variable está definida con echo $XAI_API_KEY |
400 Bad Request | Un argumento no válido en el cuerpo o la URL, o una clave de API incorrecta | Revisa el JSON, la dirección del endpoint y la clave |
403 Forbidden | Tu clave o tu equipo no tienen permiso, o están bloqueados | Pide permiso al administrador de tu equipo |
404 Not Found | No se encontró el modelo de la solicitud, o la URL está mal escrita | Revisa la ortografía grok-4.7 y la dirección del endpoint |
415 Unsupported Media Type | Cuerpo vacío, o falta el encabezado Content-Type: application/json | Añade el encabezado y un cuerpo válido |
422 Unprocessable Entity | Un campo tiene un formato no válido, por ejemplo una categoría de guidelines desconocida | Compara el campo con la documentación. En el caso de las pautas, el error enumera los valores válidos |
429 Too Many Requests | Alcanzaste un límite de frecuencia | Ve más despacio y vuelve a intentarlo con una espera creciente. Los límites suben automáticamente con el gasto total de tu equipo |
Error al configurar stop, una penalización de presencia o una penalización de frecuencia | Los modelos de razonamiento no los aceptan | Elimínalos |
| La solicitud agota el tiempo de espera | El razonamiento tardó más de lo que permite tu cliente | Aumenta el tiempo de espera de tu cliente (los ejemplos de la documentación usan 3.600 segundos) o baja el nivel de razonamiento |
Si todo falla a la vez, revisa status.x.ai antes de depurar tu propio código.
Conclusión
Ya tienes una clave que funciona, una primera solicitud y cinco ajustes que la mayoría de los proyectos necesitan: nivel de razonamiento, conversaciones guardadas, búsqueda web, costo por solicitud y pautas de contenido. La documentación también cubre streaming, salidas estructuradas, subida de archivos y llamadas a funciones.
Si estás comparando proveedores, nuestra guía de la API de Gemini 4 Hydrogen sigue los mismos pasos para el modelo de Google. Si prefieres tenerlo todo en tu propio equipo, mira cómo ejecutar un modelo en local con Ollama. Y si quieres a Grok en tus llamadas en lugar de en tu código, aquí tienes cómo añadir Grok a Zoom, Google Meet o Teams.
Preguntas frecuentes
¿Cuánto cuesta la API de Grok 4.7?
Para prompts de menos de 200k tokens, 2,00 US$ de entrada, 0,50 US$ de entrada en caché y 6,00 US$ de salida por cada millón de tokens. Los prompts de 200k tokens o más cuestan el doble. La búsqueda web suma 5 US$ por cada 1.000 llamadas. Precios a 15 de noviembre de 2026.
¿Puedo usar el SDK de OpenAI con la API de Grok?
Sí. Apunta el SDK de OpenAI para Python o JavaScript a la URL base https://api.x.ai/v1 con tu XAI_API_KEY y llama a responses.create con el modelo grok-4.7. xAI también tiene su propio paquete xai-sdk, y la documentación dice que combinarlos no es problema.
¿Por qué mi solicitud a la API de Grok agota el tiempo de espera?
Grok 4.7 siempre razona antes de responder, y el razonamiento profundo puede tardar. Aumenta el tiempo de espera de tu cliente (los ejemplos de la documentación usan 3.600 segundos) o baja el nivel de razonamiento.
¿Se puede desactivar el razonamiento en Grok 4.7?
No. Grok 4.7 siempre razona antes de responder. Solo puedes fijar el esfuerzo en low, medium, high o xhigh, y high es el predeterminado.
Test rápido
¿Cuál es el nivel de razonamiento predeterminado de Grok 4.7?
- low (bajo)
- medium (medio)
- high (alto)
La guía de razonamiento fija high como valor predeterminado.
¿Cuántos ticks hacen un dólar estadounidense?
- 10,000,000,000
- 1,000,000
- 37,756,000
La guía de control de costos dice que un dólar estadounidense equivale a 10.000.000.000 ticks.
¿Qué suele significar un error 401 Unauthorized?
- Alcanzaste un límite de frecuencia
- Falta un encabezado o la clave no es válida
- El nombre del modelo está mal escrito
La página de depuración de xAI señala como causa la falta del encabezado de autorización o una clave no válida.
Fuentes
Enlaces revisados por última vez el 15 de noviembre de 2026.



Escribe una respuesta