Grok 4.7 est le modèle le plus récent et le plus performant de l’API xAI, et vous pouvez l’appeler depuis un terminal ou un petit script en quelques minutes. Ce guide vous accompagne pas à pas : créer une clé, envoyer une première requête avec curl, Python et JavaScript, puis utiliser les fonctions dont vous aurez besoin ensuite : niveau de raisonnement, questions de suivi, recherche web en direct, suivi des coûts et nouvelles consignes de contenu. Les commandes suivent la documentation officielle sur docs.x.ai, vérifiée le 15 novembre 2026.
À retenir
- Grok 4.7 est le modèle le plus performant de l’API xAI, avec une fenêtre de contexte de 500 000 tokens.
- Créez une clé sur console.x.ai, enregistrez-la sous XAI_API_KEY et appelez la Responses API avec curl ou le SDK OpenAI.
- Réglez le niveau de raisonnement de low à xhigh, poursuivez une conversation avec previous_response_id et ajoutez l’outil web_search pour des réponses à jour.
- Chaque réponse indique son prix exact dans cost_in_usd_ticks, et des consignes facultatives refusent les contenus nsfw, violence ou profanity.
Une remarque sur le nom : la documentation appelle désormais l’entreprise SpaceXSI, mais le service s’appelle toujours « the xAI API », l’adresse reste api.x.ai et la variable de la clé reste XAI_API_KEY.
Ce qu’il vous faut
- Un compte sur console.x.ai avec des crédits. Le guide de démarrage rapide demande de charger des crédits avant d’utiliser l’API.
- Un terminal avec
curl. Cela suffit pour tout le guide. - Facultatif : Python avec
pip, ou Node.js avecnpm, si vous voulez appeler l’API depuis du code.
Grok 4.7 en un coup d’œil
Ces chiffres proviennent de la page Grok 4.7 et de la page des tarifs au 15 novembre 2026. Les prix évoluent : vérifiez-les avant d’établir un budget.
| Caractéristique | Valeur |
|---|---|
| Nom du modèle | grok-4.7 |
| Fenêtre de contexte | 500 000 tokens |
| Date limite des connaissances | Mai 2026 |
| Entrée | Texte et images |
| Sortie | Texte |
| Prix, prompts de moins de 200k tokens | 2,00 $ en entrée, 0,50 $ en entrée mise en cache, 6,00 $ en sortie par million de tokens |
| Prix, prompts de 200k tokens ou plus | 4,00 $ en entrée, 1,00 $ en entrée mise en cache, 12,00 $ en sortie par million de tokens |
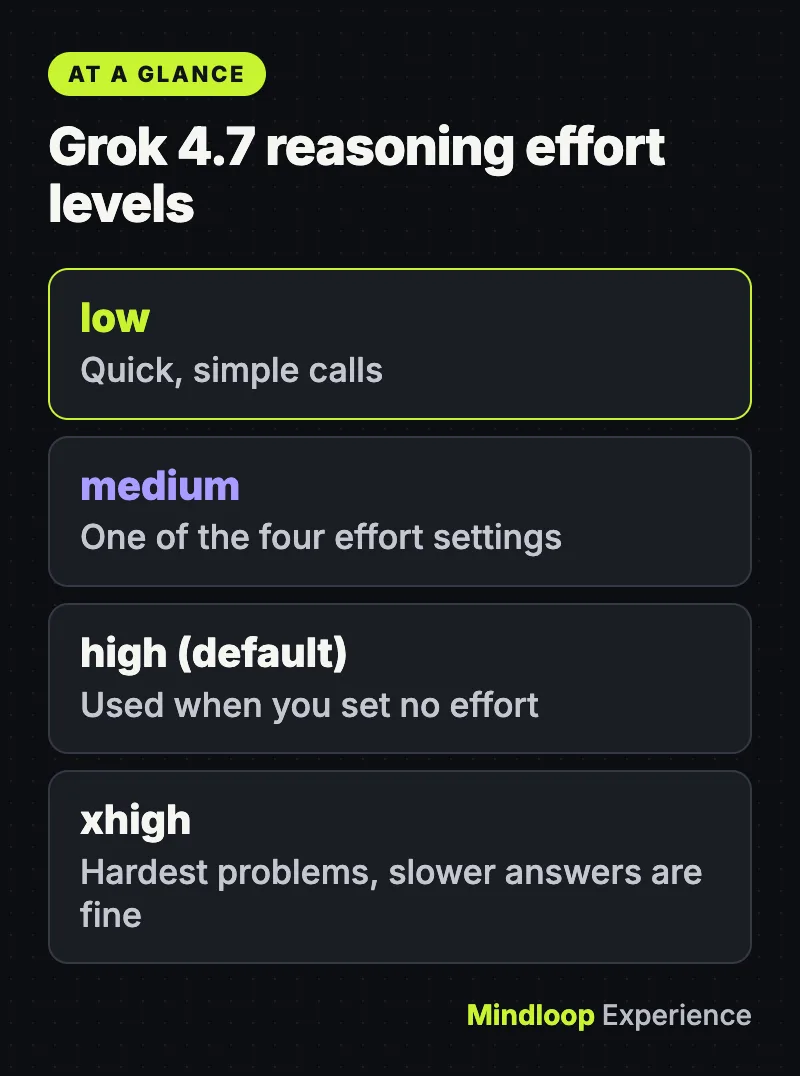
| Niveau de raisonnement | low, medium, high (par défaut) ou xhigh |
En chiffres
500 000 tokensfenêtre de contexte
2,00 $en entrée par million de tokens, sous 200k
6,00 $en sortie par million de tokens, sous 200k
Étape 1 : créer une clé API
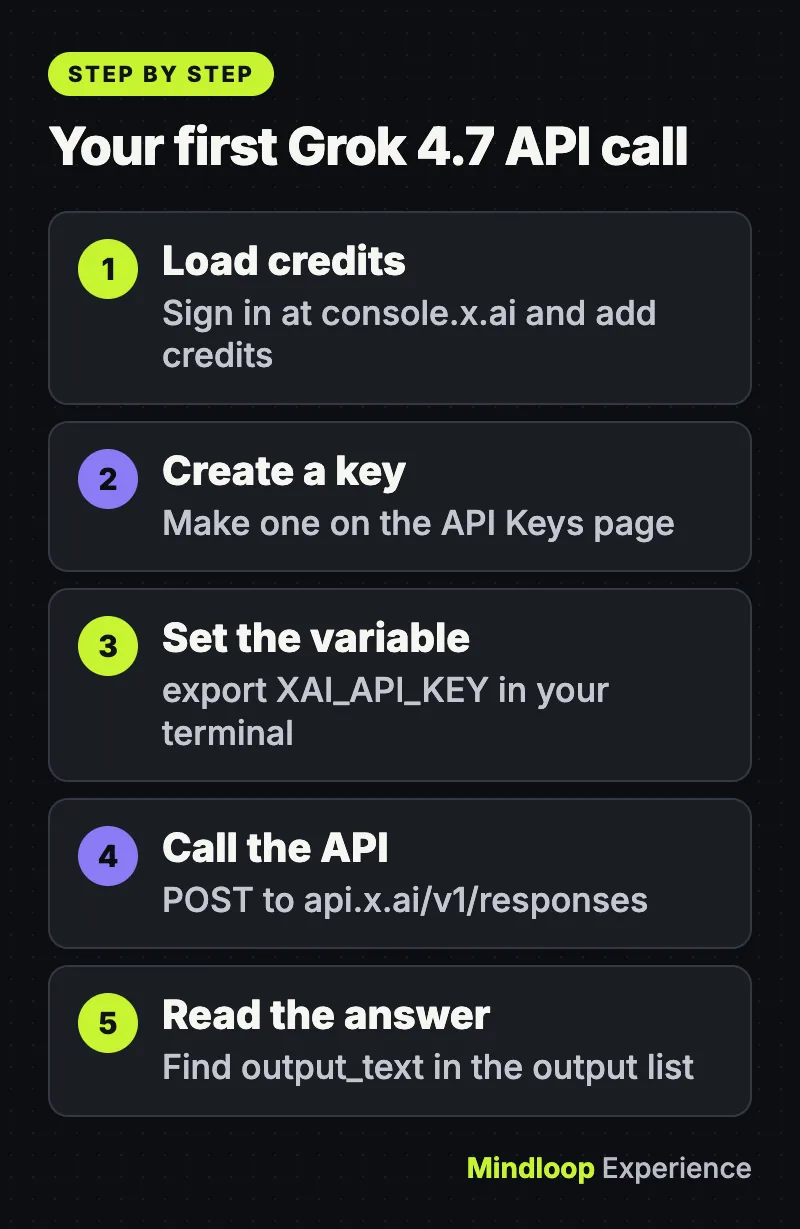
- Connectez-vous sur console.x.ai et ajoutez des crédits.
- Ouvrez la page API Keys et créez une clé.
- Stockez-la dans une variable d’environnement pour qu’elle ne figure jamais dans votre code :
export XAI_API_KEY="your_api_key"Sous Windows PowerShell, utilisez plutôt $env:XAI_API_KEY="your_api_key". Traitez la clé comme un mot de passe. Ne la collez pas dans des documents partagés et ne la commitez pas dans un dépôt.
Étape 2 : envoyer votre première requête avec curl
La documentation recommande la Responses API, à l’adresse https://api.x.ai/v1/responses. Voici l’exemple du guide de démarrage rapide :
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.7",
    "input": "Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}"
  }'
Résultat attendu : un objet JSON. La réponse se trouve dans la liste output, dans un élément de type message dont le contenu est de type output_text. Le même objet contient un id (vous l’utiliserez à l’étape 5) et un bloc usage avec le nombre de tokens.
Étape 3 : l’appeler depuis Python ou JavaScript
L’API fonctionne avec les SDK OpenAI si vous les faites pointer vers l’URL de base de xAI. Installez-en un :
pip install openainpm install openaiPython :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("XAI_API_KEY"),
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.7",
    input="Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}",
)

print(response.output_text)
JavaScript (enregistrez-le dans un fichier .mjs pour que import et await au niveau supérieur fonctionnent dans Node.js) :
import OpenAI from 'openai';

const client = new OpenAI({
  apiKey: process.env.XAI_API_KEY,
  baseURL: 'https://api.x.ai/v1',
});

const response = await client.responses.create({
  model: 'grok-4.7',
  input: 'Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}',
});

console.log(response.output_text);
Les deux n’affichent que le texte du modèle. xAI propose aussi son propre paquet Python (pip install xai-sdk), et la documentation indique qu’on peut mélanger les deux sans problème.
Étape 4 : choisir à quel point le modèle réfléchit
Grok 4.7 raisonne toujours avant de répondre. Impossible de le désactiver, mais le guide du raisonnement vous permet de régler l’effort. La valeur par défaut est high. Utilisez low pour les appels simples et rapides, et xhigh pour les problèmes les plus difficiles, quand une réponse plus lente est acceptable.
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -m 3600 \
  -d '{
    "model": "grok-4.7",
    "reasoning": {"effort": "low"},
    "input": "Summarise the difference between TCP and UDP in three bullet points."
  }'
L’option -m 3600 laisse la requête tourner jusqu’à une heure avant que curl abandonne. La documentation l’utilise dans ses exemples de raisonnement, car un raisonnement poussé peut prendre du temps. En Python, le même réglage s’écrit reasoning={"effort": "low"}.
Étape 5 : poser une question de suivi sans renvoyer la conversation
Par défaut, la Responses API conserve chaque échange sur les serveurs de xAI pendant 30 jours, selon le guide de génération de texte. Vous pouvez donc poursuivre une conversation en transmettant l’id de la réponse précédente :
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -m 3600 \
  -d '{
    "model": "grok-4.7",
    "previous_response_id": "The previous response ID",
    "input": [
        {
            "role": "user",
            "content": "How do stars form?"
        }
    ]
}'
Remplacez l’espace réservé par l’id de votre réponse précédente. Si vous préférez que les requêtes ne soient pas conservées, ajoutez "store": false à la requête et gérez vous-même l’historique.
Le saviez-vous ?
Par défaut, la Responses API conserve chaque échange sur les serveurs de xAI pendant 30 jours. Ajoutez « store »: false à une requête si vous préférez gérer vous-même l’historique de la conversation.
Étape 6 : laisser Grok chercher sur le web
La page des modèles est sans détour : sans outils de recherche, Grok ne sait rien au-delà de ses données d’entraînement. Pour obtenir des réponses à jour, ajoutez l’outil de recherche web :
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
  "model": "grok-4.7",
  "input": [
    {
      "role": "user",
      "content": "What were the main technology headlines this week?"
    }
  ],
  "tools": [
    {
      "type": "web_search"
    }
  ]
}'
Grok décide lui-même du nombre de recherches. Au 15 novembre 2026, la recherche web coûte 5 $ pour 1 000 appels en plus des frais de tokens habituels, donc un prompt qui demande beaucoup de recherches coûte plus cher qu’un prompt simple.
Étape 7 : voir combien a coûté chaque requête
Chaque réponse indique son prix exact dans un champ appelé cost_in_usd_ticks, décrit dans le guide du suivi des coûts. Un dollar américain vaut 10 000 000 000 ticks. Si jq est installé, cette commande affiche le chiffre pour un seul appel :
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.7",
    "input": "Say hello"
  }' | jq '.usage.cost_in_usd_ticks'
Divisez le résultat par 10 000 000 000 pour obtenir des dollars. L’exemple de la documentation : 37756000 ticks font environ 0,0038 $.
Le saviez-vous ?
xAI facture les requêtes en ticks : un dollar américain vaut 10 000 000 000 ticks. L’exemple de la documentation, 37756000 ticks, revient à environ 0,0038 $.
Étape 8 (facultative) : ajouter des consignes de contenu
En octobre 2026, xAI a ajouté des contrôles de modération personnalisés. Vous joignez une liste guidelines à une requête, et Grok refuse ce type de contenu pendant qu’il écrit. Il existe trois catégories, nsfw, violence et profanity, et le seul comportement disponible aujourd’hui est decline.
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.7",
    "input": "Write a short story about a knight.",
    "guidelines": [
      { "type": "policy", "category": "violence", "behavior": "decline" },
      { "type": "policy", "category": "nsfw", "behavior": "decline" }
    ]
  }'
Les consignes ne s’appliquent qu’à la requête qui les contient : envoyez-les donc à chaque fois. Avec le SDK OpenAI pour Python, passez la liste dans extra_body, car ce SDK n’a pas de paramètre guidelines propre.
Erreurs courantes et solutions
Les codes d’état ci-dessous proviennent de la page de débogage de xAI et des guides cités plus haut.
| Ce que vous voyez | Cause probable | Solution |
|---|---|---|
401 Unauthorized | Pas d’en-tête d’autorisation, ou une clé invalide | Envoyez Authorization: Bearer <your key> et vérifiez que la variable est définie avec echo $XAI_API_KEY |
400 Bad Request | Un argument invalide dans le corps ou l’URL, ou une clé API incorrecte | Vérifiez le JSON, l’adresse du endpoint et la clé |
403 Forbidden | Votre clé ou votre équipe n’a pas l’autorisation, ou est bloquée | Demandez l’autorisation à l’administrateur de votre équipe |
404 Not Found | Le modèle demandé est introuvable, ou l’URL est mal orthographiée | Vérifiez l’orthographe grok-4.7 et l’adresse du endpoint |
415 Unsupported Media Type | Corps vide, ou en-tête Content-Type: application/json manquant | Ajoutez l’en-tête et un corps valide |
422 Unprocessable Entity | Un champ a un format invalide, par exemple une catégorie guidelines inconnue | Comparez le champ avec la documentation. Pour les consignes, l’erreur liste les valeurs valides |
429 Too Many Requests | Vous avez atteint une limite de débit | Ralentissez et réessayez avec un délai croissant. Les limites augmentent automatiquement avec les dépenses totales de votre équipe |
Erreur quand vous définissez stop, une pénalité de présence ou une pénalité de fréquence | Les modèles de raisonnement ne les acceptent pas | Supprimez-les |
| La requête expire | Le raisonnement a pris plus de temps que votre client ne l’autorise | Augmentez le délai d’expiration de votre client (les exemples de la documentation utilisent 3 600 secondes) ou baissez le niveau de raisonnement |
Si tout échoue en même temps, consultez status.x.ai avant de déboguer votre propre code.
En résumé
Vous avez maintenant une clé fonctionnelle, une première requête et cinq réglages dont la plupart des projets ont besoin : niveau de raisonnement, conversations conservées, recherche web, coût par requête et consignes de contenu. La documentation couvre aussi le streaming, les sorties structurées, l’envoi de fichiers et l’appel de fonctions.
Si vous comparez les fournisseurs, notre guide de l’API Gemini 4 Hydrogen suit les mêmes étapes pour le modèle de Google. Si vous préférez tout garder sur votre propre machine, découvrez comment exécuter un modèle en local avec Ollama. Et si vous voulez Grok dans vos appels plutôt que dans votre code, voici comment ajouter Grok à Zoom, Google Meet ou Teams.
Questions fréquentes
Combien coûte l’API Grok 4.7 ?
Pour les prompts de moins de 200k tokens : 2,00 $ en entrée, 0,50 $ en entrée mise en cache et 6,00 $ en sortie par million de tokens. Les prompts de 200k tokens ou plus coûtent le double. La recherche web ajoute 5 $ pour 1 000 appels. Prix au 15 novembre 2026.
Puis-je utiliser le SDK OpenAI avec l’API Grok ?
Oui. Faites pointer le SDK OpenAI pour Python ou JavaScript vers l’URL de base https://api.x.ai/v1 avec votre XAI_API_KEY et appelez responses.create avec le modèle grok-4.7. xAI propose aussi son propre paquet xai-sdk, et la documentation indique qu’on peut les combiner.
Pourquoi ma requête à l’API Grok expire-t-elle ?
Grok 4.7 raisonne toujours avant de répondre, et un raisonnement poussé peut prendre du temps. Augmentez le délai d’expiration de votre client (les exemples de la documentation utilisent 3 600 secondes) ou baissez le niveau de raisonnement.
Peut-on désactiver le raisonnement de Grok 4.7 ?
Non. Grok 4.7 raisonne toujours avant de répondre. Vous pouvez seulement régler l’effort sur low, medium, high ou xhigh, high étant la valeur par défaut.
Petit quiz
Quel est le niveau de raisonnement par défaut de Grok 4.7 ?
- low (faible)
- medium (moyen)
- high (élevé)
Le guide du raisonnement fixe high comme valeur par défaut.
Combien de ticks font un dollar américain ?
- 10,000,000,000
- 1,000,000
- 37,756,000
D’après le guide du suivi des coûts, un dollar américain vaut 10 000 000 000 ticks.
Que signifie le plus souvent une erreur 401 Unauthorized ?
- Vous avez atteint une limite de débit
- Un en-tête manquant ou une clé invalide
- Le nom du modèle est mal orthographié
La page de débogage de xAI indique comme cause l’absence d’en-tête d’autorisation ou une clé invalide.
Sources
Liens vérifiés pour la dernière fois le 15 novembre 2026.



Écrire une réponse