Google bracht Gemini 4 Neon uit op 18 november 2026: een middenmodel dat Google tussen Hydrogen en Carbon plaatst. Volgens Google’s eigen meting kost het per taak minder dan Carbon, maar tot 30 november is de prijs per token hoger dan die van Carbon. Hier lees je waar je het kunt gebruiken, hoe je je eerste API-aanroep doet in Python, JavaScript of curl, welk denkniveau je kiest, wat een agent-run kost en welke fouten je tegenkomt als je een app overzet. Elke prijs, limiet en elk codevoorbeeld komt uit de eigen documentatie van Google, gecontroleerd op 20 november 2026.
De belangrijkste punten
- Gemini 4 Neon zit tussen Hydrogen en Carbon in en kost $3,00 input en $15,00 output per 1M tokens.
- In de API is Neon alleen beschikbaar in de betaalde tier; abonnees van Pro en Ultra kunnen het kiezen in de Gemini-app.
- Standaard gebruikt het denkniveau high, het voegt xhigh toe en weigert minimal; kies het laagste niveau dat je tests haalt.
- Tot 30 november is Carbon per token goedkoper; vanaf 1 december verdubbelt Carbon naar $4,00 en $20,00.
Wat is er nieuw: Gemini 4 Neon in één minuut
Neon (model-ID gemini-4-neon) is het nieuwe middenmodel van Google in de Gemini 4-familie. Volgens de pagina What’s new in Gemini 4 Neon “sits between Gemini 4 Hydrogen and Gemini 4 Carbon for high-frequency complex tasks” (zit het tussen Gemini 4 Hydrogen en Gemini 4 Carbon, voor complexe taken die vaak terugkomen), zoals refactoring over meerdere bestanden, compacte documenten en wetenschappelijke workflows. De modelkaart meldt dat Neon is afgeleid van Gemini 4 Carbon en een kennisgrens heeft van maart 2026.
De basis, volgens de modelpagina van Gemini 4 Neon:
- Invoer: tekst, afbeeldingen, video, audio en pdf. Uitvoer: alleen tekst (geen beeld- of audiogeneratie, geen Live API).
- Context: één gedeeld venster van 1.048.576 tokens voor input, denken en output samen.
- Max. output: standaard 65.536 tokens per synchroon antwoord, tot 1.048.576 met long decode.
- Tools: function calling, structured outputs, code execution, computer use, en grounding met Search en Maps.
- Caching: alleen impliciete caching. Expliciete caching wordt niet ondersteund.
De aankondiging van Google noemt deze resultaten (cijfers van Google zelf): een score van 61 op de Artificial Analysis Intelligence Index op denkniveau xhigh (#3 overall), 65,2% op Terminal-Bench 4.1 en 70,9% op de Vals Index. In de tabel van de modelkaart zelf staat Claude Opus 5.5 op Terminal-Bench 4.1 net iets hoger (65,8%). Google zegt ook dat Neon op het standaardniveau high “a 32% lower cost per task than Carbon” heeft (32% lagere kosten per taak dan Carbon). Dat is een claim per taak, omdat het model minder tokens gebruikt, en geen lagere prijs per token.
In cijfers
1.048.576tokens gedeeld contextvenster
65.536standaard max. outputtokens
$3,00per 1M inputtokens
Waar je Gemini 4 Neon kunt gebruiken
Volgens de aankondiging van Google wordt Neon hier uitgerold:
| Waar | Wie het krijgt | Hoe je het kiest |
|---|---|---|
| Gemini API (Google AI Studio) | Alleen ontwikkelaars in de betaalde tier | model: "gemini-4-neon" |
| Gemini-app | Abonnees van Google AI Pro en Ultra | Keuzemenu voor het model |
| Google AI Studio | Abonnees van Google AI Pro en Ultra | Niet vermeld in de aankondiging |
| Google Antigravity | Betalende abonnees van Google AI Pro en Ultra | Niet vermeld in de aankondiging |
| Gemini voor bedrijven | Zakelijke klanten | API of keuzemenu voor het model |
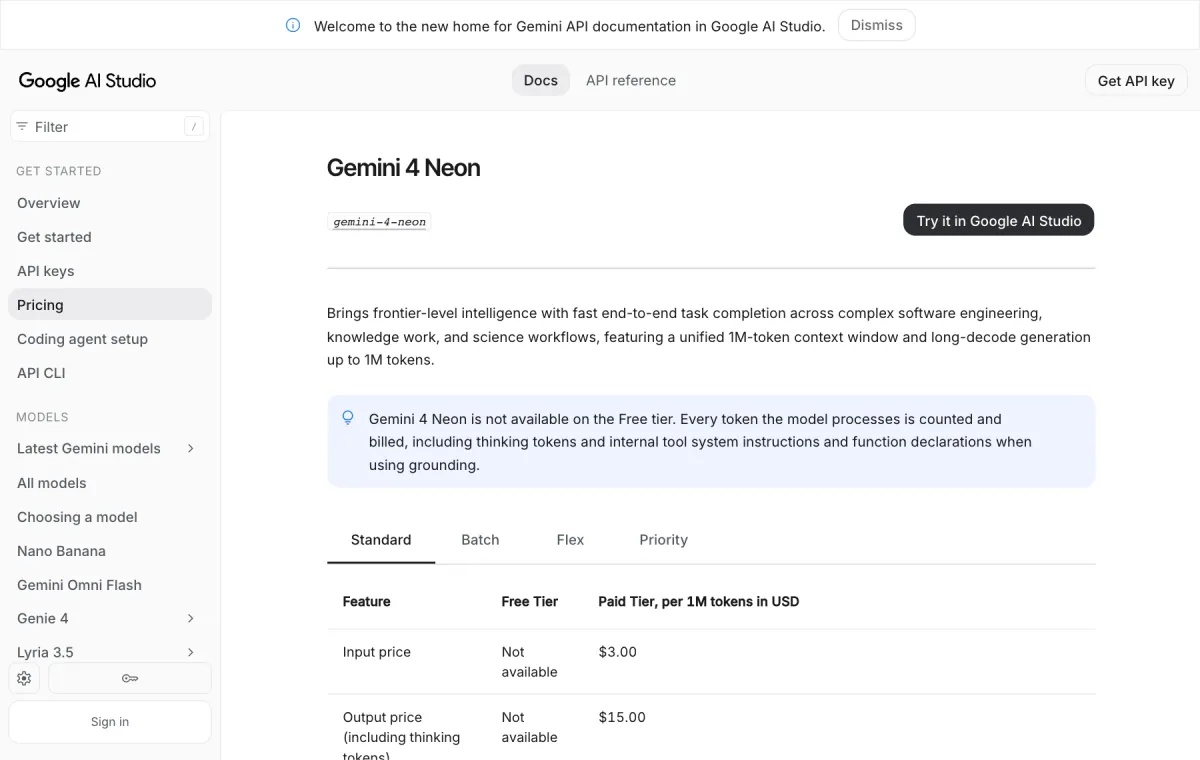
De API heeft geen gratis tier voor Neon: op de prijspagina staat bij elke gratis-tierprijs van Neon “Not available” (niet beschikbaar), net als bij Carbon. Hydrogen is het Gemini 4-model dat je nog gratis kunt proberen. De aankondiging van Google noemt geen landen. Zit je in de VS, het Verenigd Koninkrijk of de Golfregio, kijk dan in het keuzemenu van de Gemini-app met een Pro- of Ultra-abonnement, of doe een testaanroep vanuit een betaald AI Studio-project. Wat die abonnementen kosten in de VAE lees je in onze gids over ChatGPT- en Gemini-abonnementen en prijzen in AED in de VAE.
Wat je nodig hebt
- Een Google-account met toegang tot Google AI Studio.
- Een Google Cloud-factureringsaccount dat aan je AI Studio-project is gekoppeld. Volgens de factureringsgids van Google betekent overstappen naar de betaalde tier dat je een factureringsaccount koppelt en op het Prepay-abonnement minimaal $5 aan tegoed vooruitbetaalt (sommige accounts krijgen in plaats daarvan Postpay aangeboden of toegewezen).
- Python met
pip, of Node.js metnpm, of gewooncurl.
De Gemini 4 Neon API instellen, stap voor stap
- Haal een API-sleutel op. Open de pagina met API-sleutels in AI Studio. Voor nieuwe gebruikers maakt Google automatisch een project en sleutel aan; klik anders op Create API key (API-sleutel maken) en volg het venster om een combinatie van sleutel en project toe te voegen.
- Zet facturering aan voor dat project. Zoek op dezelfde pagina met API-sleutels (of op de pagina Projects) het project op en klik op Set up billing (facturering instellen) in de kolom Billing Tier. Nieuwe gebruikers kiezen een land, accepteren de voorwaarden en voegen een betaalmethode toe; bestaande gebruikers kiezen een factureringsaccount. Betaal daarna de minimale $5 vooruit als daarom wordt gevraagd.
- Sla de sleutel op als omgevingsvariabele. De SDK’s lezen
GEMINI_API_KEYautomatisch uit. Op macOS of Linux:
export GEMINI_API_KEY="YOUR_API_KEY"- Installeer de SDK. Dit zijn de officiële Google GenAI-bibliotheken:
pip install -U google-genainpm install @google/genai- Stuur je eerste verzoek met de Interactions API. In Python, uit de Neon-documentatie:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)

print(interaction.output_text)
De JavaScript-versie:
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

const interaction = await client.interactions.create({
  model: "gemini-4-neon",
  input: "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic.",
});

console.log(interaction.output_text);
En de REST-aanroep met curl:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
}'- Houd je uitgaven in de gaten. Je verbruik zie je in AI Studio onder Dashboard > Usage, en de gids over API-sleutels van Google raadt aan om factureringsmeldingen in te stellen in de Google Cloud-console.
Overstappen vanaf een ander Gemini 4-model “requires no request schema changes” (vraagt geen wijzigingen in het verzoekschema) behalve het model-ID, het denkniveau en een betaald project, volgens de migratiechecklist van Google. Onze gids voor de Gemini 4 Hydrogen API gaat dieper in op de gedeelde setup.

Denkniveaus van Gemini 4 Neon: welke gebruik je?
Het denkniveau is je belangrijkste knop voor kwaliteit, latentie en kosten. Neon ondersteunt low, medium, high (standaard) en xhigh, maar niet minimal, dat Gemini 3.5 Flash-Lite en sommige oudere modellen wel gebruiken. De documentatie van Google beschrijft ze zo:
| Niveau | Tokengebruik | Geschikt voor |
|---|---|---|
low | Minste tokens, laagste latentie | Snelle chat, verwerking met hoge doorvoer; nog steeds sterk bij agent-taken |
medium | Lager tokengebruik, snellere antwoorden | Interactief programmeren, live UI-prototypes, vlotte chat, snelle tool calls |
high (standaard) | Gebalanceerd | De meeste taken: complex programmeren, agents, tool calling, multimodaal kenniswerk |
xhigh | Meeste tokens, diepste redenering | Lastige engineering in meerdere stappen, analytische en wetenschappelijke problemen waar high tekortschiet |
Je stelt het in via generation_config. Dit is het eigen xhigh-voorbeeld van Google in Python:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh"
    }
)

print(interaction.output_text)
In REST komt hetzelfde veld in de JSON-body als "generation_config": {"thinking_level": "xhigh"}. Het advies van Google: draai je evaluaties op alle vier de niveaus met een hoge max_output_tokens en kies dan het laagste niveau dat je kwaliteitslat haalt. Denktokens worden gefactureerd als outputtokens, dus van high naar medium gaan is vaak een goedkopere oplossing dan van model wisselen. De gids over denken vertelt meer.
Wist je dat?
Denktokens worden bij Neon gefactureerd als outputtokens. Van denkniveau high naar medium gaan is daarom vaak een goedkopere oplossing dan overstappen naar een kleiner model.
Neon vs. Hydrogen vs. Carbon: prijstabel en wanneer je welke kiest
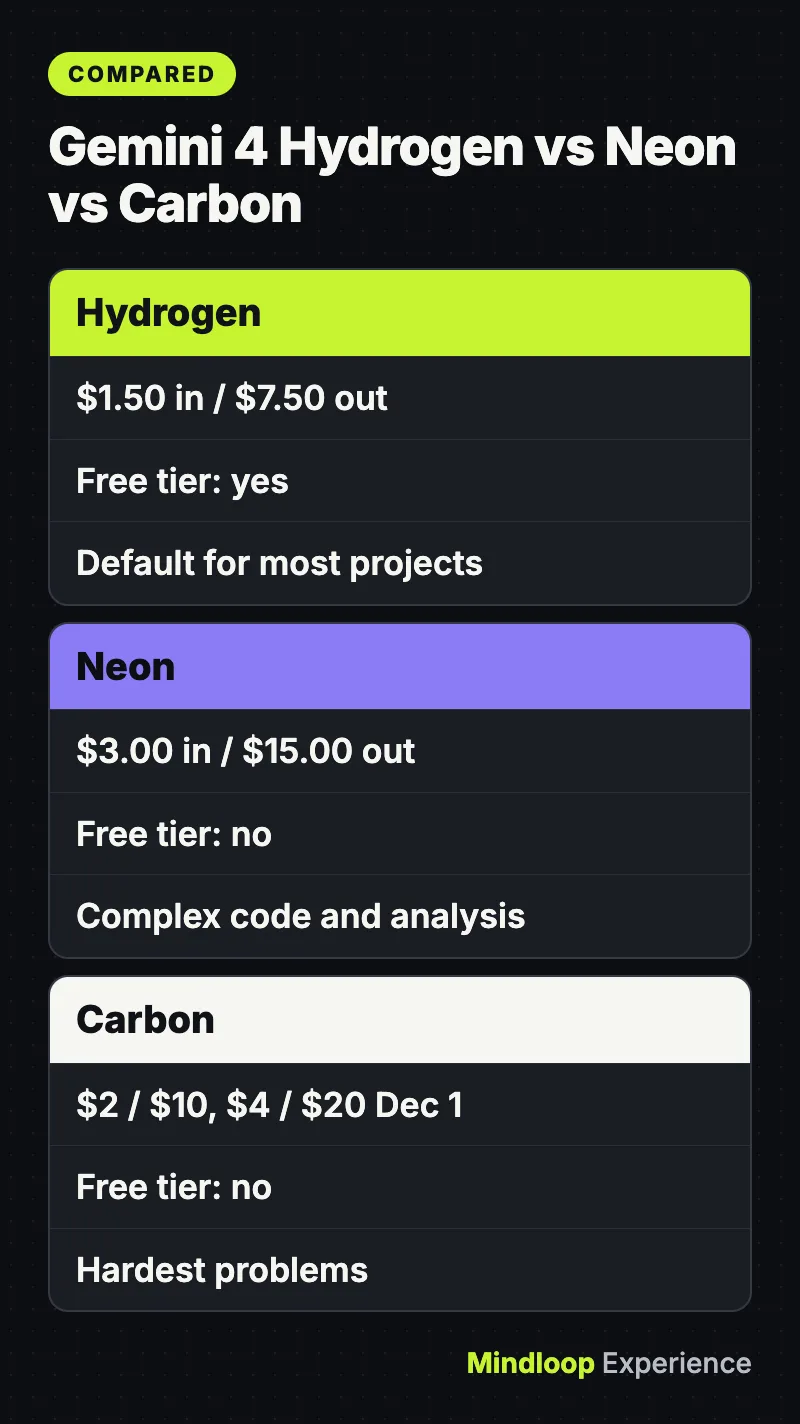
Standaardprijzen in de betaalde tier per 1 miljoen tokens, van de prijspagina van Google op 20 november 2026. Outputprijzen zijn inclusief denktokens.
| Model | Input | Output | Gecachete input | Batch / Flex (in / uit) | Gratis tier |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Ja |
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | Nee |
| Gemini 4 Carbon, tot en met 30 nov. 2026 | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | Nee |
| Gemini 4 Carbon, vanaf 1 dec. 2026 | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | Nee |
Gemini 4 Argon heeft dezelfde prijzen als Carbon. De Priority-tier van Neon kost $5,40 input en $27,00 output. De prijs van Neon is gelijk over het hele venster van 1M, en de pagina Choosing a model van Google merkt op dat “Neon has no introductory price” (Neon heeft geen introductieprijs). Tot 30 november is Carbon dus per token goedkoper; vanaf 1 december verdubbelt Carbon en wordt Neon de goedkoopste van de twee.
Het eigen advies van Google voor de keuze:
- Hydrogen: de standaard voor de meeste nieuwe projecten, dagelijks programmeerwerk en parallelle worker-agents, voor de helft van de prijs van Neon.
- Neon: complexe software-engineering, compact kenniswerk en wetenschappelijke workflows “where Hydrogen isn’t enough and you don’t need Carbon’s extra verification” (waar Hydrogen niet genoeg is en je de extra verificatie van Carbon niet nodig hebt). Google noemt het ook als upgrade voor
gemini-3.1-pro-preview. - Carbon: je moeilijkste problemen, zoals systeemarchitectuur, formele bewijzen en beveiligingsaudits, met meer denktokens per beurt. Lees ook ons artikel over Gemini 4 Carbon bovenaan MathArena.
De drie delen één verzoekschema, dus je kunt previous_interaction_id meegeven om een gesprek van het ene model aan het andere over te dragen, bijvoorbeeld Carbon voor het plan en Hydrogen voor het schrijven van de code.
Rekenvoorbeeld: één agent-run op Standard vs. Batch
Stel dat een agent-run 200.000 inputtokens verstuurt (een coderepository plus instructies) en 20.000 outputtokens terugkrijgt, denken meegerekend. Tegen de lijstprijzen van Google (het echte aantal tokens hangt af van de taak en het denkniveau):
- Neon, Standard: 0,2M × $3,00 = $0,60 input, plus 0,02M × $15,00 = $0,30 output. Totaal $0,90.
- Neon, Batch of Flex: 0,2M × $1,50 = $0,30, plus 0,02M × $7,50 = $0,15. Totaal $0,45.
- Neon, Priority: 0,2M × $5,40 = $1,08, plus 0,02M × $27,00 = $0,54. Totaal $1,62.
- Neon, Standard, waarbij 150.000 van de inputtokens uit de impliciete cache komen: 0,15M × $0,15 = $0,0225, plus 0,05M × $3,00 = $0,15, plus $0,30 output. Totaal ongeveer $0,47.
- Hydrogen, Standard: $0,30 + $0,15 = $0,45.
- Carbon, Standard: $0,40 + $0,20 = $0,60 tot en met 30 november, of $0,80 + $0,40 = $1,20 vanaf 1 december.
Bij 1.000 runs is dat $900 voor Neon op Standard tegenover $450 op Batch. Impliciete caching werkt bij prompts van minstens 4.096 tokens en geeft 95% korting op gecachete input. Zet gedeelde instructies, tooldefinities en referentiebestanden dus vooraan. Een model dat minder tokens nodig heeft voor dezelfde taak, wat Google voor Neon tegenover Carbon claimt, kost per afgeronde taak minder dan deze berekening laat zien.
Nieuwe betaalde accounts hebben ook uitgavenlimieten. De pagina over rate limits noemt een uitgavenlimiet van $10 per 10 minuten voor Tier 1 (of die voor jou geldt, hangt af van je account). Dat zijn ongeveer 11 van de Standard-runs hierboven. De factureringsgids hanteert voor Tier 1 een maandplafond van $250.
Wist je dat?
Impliciete caching werkt automatisch bij prompts van minstens 4.096 tokens en geeft 95% korting op gecachete input. Gecachete Neon-input kost dan $0,15 per miljoen tokens.
Veelvoorkomende fouten en oplossingen
- Neon werkt niet met je sleutel uit de gratis tier. Het wordt niet aangeboden in de gratis tier. Klik op Set up billing op de pagina met API-sleutels of op de pagina Projects. Staat er bij het project “Set up Prepay” of “No credits”, rond dan de Prepay-setup af of voeg tegoed toe. Volgens de factureringsgids verwerkt de API alleen verzoeken in de betaalde tier zolang je Prepay-saldo positief is.
thinking_level: "minimal"mislukt. Neon weigertminimalmet een foutmelding. Gebruik in plaats daarvanlow.- Code voor expliciete caching werkt niet meer. Neon ondersteunt geen expliciete caching (
cachedContentsencaches.create). Verwijdercached_content-velden en vertrouw op impliciete caching. - Validatiefouten
400na de migratie. Verwijdertemperature,top_pentop_k. De server negeert waarden binnen het bereik, maar waarden buiten het bereik geven een400-fout. - Antwoorden stoppen te vroeg.
max_output_tokensbegrenst denken en output samen. Haal oude, lage limieten zoals 8.192 weg of verhoog de limiet naar 65.536. Voor langere output zet jebackgroundoptrueenmax_output_tokensboven 65.536 (bijvoorbeeld 131.072 of 262.144). Metbackground: truemaar zondermax_output_tokensstopt de server na 65.536 tokens. Zie de gids over long decode van Google. MALFORMED_FUNCTION_CALL. Dit kan gebeuren als een systeemprompt om ruwe JSON-tool calls vraagt terwijl er geen tools zijn gedeclareerd. Declareer tools met function calling, of gebruik structured outputs. Heeft je code alleen een ja/nee of een score nodig, dan laat onze quickstart voor de Gemini Decisions API een goedkopere route zien.429 RESOURCE_EXHAUSTED. Een gedocumenteerde oorzaak is de uitgavenlimiet. Wacht en probeer het opnieuw, of stuur kleinere contexten.- Verzoeken lopen in een time-out. Volgens Google kunnen moeilijke prompts meerdere minuten duren. Gebruik uitvoering op de achtergrond, of zet de time-outs van je HTTP-client op minstens 15 minuten.
Tot slot
Gebruik Neon als Hydrogen tekortschiet bij code over meerdere bestanden, lange documenten of analyses en je het extra denkwerk van Carbon niet nodig hebt. Begin op high, test medium, bewaar xhigh voor de zwaarste klussen en stuur werk zonder haast via Batch of Flex voor de halve prijs. Wil je het gewoon proberen, dan is de Gemini-app met een Pro- of Ultra-abonnement het snelst, want de API vraagt vanaf de eerste aanroep om facturering. Hydrogen blijft het gratis startpunt, en Google heeft het ook naar Search gebracht, zoals je leest in de Gemini 4 Hydrogen-upgrade van Google Search. Meer gidsen zoals deze vind je in onze rubriek AI-gidsen.
Veelgestelde vragen
Is Gemini 4 Neon gratis te gebruiken?
Niet in de API. Op de prijspagina van Google staat elke gratis-tierprijs van Neon als niet beschikbaar, dus je hebt een betaald AI Studio-project met gekoppelde facturering nodig. Abonnees van Google AI Pro en Ultra kunnen Neon kiezen in de Gemini-app, en Hydrogen heeft nog steeds een gratis tier.
Wat is het model-ID van Gemini 4 Neon?
Het model-ID is gemini-4-neon. Volgens de migratiechecklist van Google vraagt overstappen vanaf een ander Gemini 4-model geen wijzigingen in het verzoekschema, behalve het model-ID, het denkniveau en een betaald project.
Is Gemini 4 Neon goedkoper dan Gemini 4 Carbon?
Niet per token tot en met 30 november 2026: Carbon kost dan $2,00 en $10,00 per miljoen tokens, tegenover $3,00 en $15,00 voor Neon. Vanaf 1 december stijgt Carbon naar $4,00 en $20,00. Google zegt ook dat Neon op high 32% lagere kosten per taak heeft dan Carbon.
Ondersteunt Gemini 4 Neon context caching?
Alleen impliciete caching. Expliciete caching met cachedContents en caches.create wordt niet ondersteund, dus verwijder cached_content-velden. Impliciete caching werkt bij prompts van minstens 4.096 tokens en geeft 95% korting op gecachete input, tot $0,15 per miljoen tokens.
Snelle quiz
Wat is het standaard denkniveau van Gemini 4 Neon?
- medium
- high
- xhigh
Neon gebruikt standaard high en ondersteunt ook low, medium en xhigh; minimal accepteert het niet.
Wat kost één Neon-run met 200K input en 20K output in de Batch-tier?
- $0.45
- $0.90
- $1.62
Tegen $1,50 input en $7,50 output per miljoen tokens is dat $0,30 plus $0,15, dus $0,45.
Welk denkniveau weigert Neon met een foutmelding?
- low
- xhigh
- minimal
Neon ondersteunt low, medium, high en xhigh en weigert minimal, dus gebruik low.
Bronnen
Links voor het laatst gecontroleerd op 20 november 2026.
- What’s new in Gemini 4 Neon (Google AI Studio docs)
- Gemini 4 Neon model page (Google AI Studio docs)
- Gemini API pricing (Google AI Studio docs)
- Choosing a model (Google AI Studio docs)
- Billing (Google AI Studio docs)
- Rate limits (Google AI Studio docs)
- Gemini 4 Neon model card (Google DeepMind)
- Introducing Gemini 4 Neon (Google blog, November 18, 2026)


Schrijf een reactie