Google hat Gemini 4 Neon am 18. November 2026 veröffentlicht: ein Mittelklassemodell, das Google zwischen Hydrogen und Carbon einordnet. Pro Aufgabe ist es nach Googles eigener Messung günstiger als Carbon, pro Token aber bis zum 30. November teurer. Hier erfährst du, wo du es nutzen kannst, wie dein erster API-Aufruf in Python, JavaScript oder curl aussieht, welches Thinking-Level du wählen solltest, was ein Agent-Lauf kostet und welche Fehler dir beim Umstellen einer App begegnen. Alle Preise, Limits und Codebeispiele stammen aus Googles eigener Dokumentation, geprüft am 20. November 2026.
Das Wichtigste in Kürze
- Gemini 4 Neon liegt zwischen Hydrogen und Carbon und kostet 3,00 $ Input und 15,00 $ Output pro 1 Mio. Tokens.
- In der API gibt es Neon nur im Paid Tier; Pro- und Ultra-Abonnenten können es in der Gemini-App auswählen.
- Standard ist das Thinking-Level high, neu ist xhigh, minimal wird abgelehnt; nimm das niedrigste Level, das deine Tests besteht.
- Bis zum 30. November ist Carbon pro Token günstiger; ab dem 1. Dezember verdoppelt sich Carbon auf 4,00 $ und 20,00 $.
Was neu ist: Gemini 4 Neon in einer Minute
Neon (Modell-ID gemini-4-neon) ist Googles neues Mittelklassemodell der Gemini-4-Familie. Laut der Seite What’s new in Gemini 4 Neon liegt es „zwischen Gemini 4 Hydrogen und Gemini 4 Carbon für häufige, komplexe Aufgaben“ wie Refactoring über mehrere Dateien, dichte Dokumente und wissenschaftliche Workflows. Laut Model Card ist Neon von Gemini 4 Carbon abgeleitet und hat einen Wissensstand bis März 2026.
Die Eckdaten von der Modellseite zu Gemini 4 Neon:
- Eingaben: Text, Bild, Video, Audio und PDF. Ausgabe: nur Text (keine Bild- oder Audiogenerierung, keine Live API).
- Kontext: ein gemeinsames Fenster von 1.048.576 Tokens für Input, Thinking und Output.
- Max. Output: standardmäßig 65.536 Tokens pro synchroner Antwort, mit Long Decode bis zu 1.048.576.
- Tools: Function Calling, Structured Outputs, Code Execution, Computer Use, Grounding mit Search und Maps.
- Caching: nur implizites Caching. Explizites Caching wird nicht unterstützt.
Googles Ankündigung nennt diese Ergebnisse (Googles eigene Zahlen): 61 Punkte im Artificial Analysis Intelligence Index beim Thinking-Level xhigh (Platz 3 insgesamt), 65,2 % auf Terminal-Bench 4.1 und 70,9 % im Vals Index. Die Tabelle in der Model Card selbst zeigt Claude Opus 5.5 auf Terminal-Bench 4.1 knapp vorn (65,8 %). Außerdem sagt Google, dass Neon beim Standard-Level high „32 % niedrigere Kosten pro Aufgabe als Carbon“ hat. Das ist eine Aussage pro Aufgabe, weil weniger Tokens anfallen, kein niedrigerer Preis pro Token.
Die Zahlen
1.048.576Tokens gemeinsames Kontextfenster
65.536Output-Tokens maximal (Standard)
3,00 $pro 1 Mio. Input-Tokens
Wo du Gemini 4 Neon nutzen kannst
Laut Googles Ankündigung wird Neon hier ausgerollt:
| Wo | Wer es bekommt | So wählst du es |
|---|---|---|
| Gemini API (Google AI Studio) | Nur Entwickler im Paid Tier | model: "gemini-4-neon" |
| Gemini-App | Abonnenten von Google AI Pro und Ultra | Modell-Dropdown |
| Google AI Studio | Abonnenten von Google AI Pro und Ultra | In der Ankündigung nicht angegeben |
| Google Antigravity | Zahlende Abonnenten von Google AI Pro und Ultra | In der Ankündigung nicht angegeben |
| Gemini für Unternehmen | Geschäftskunden | API oder Modell-Dropdown |
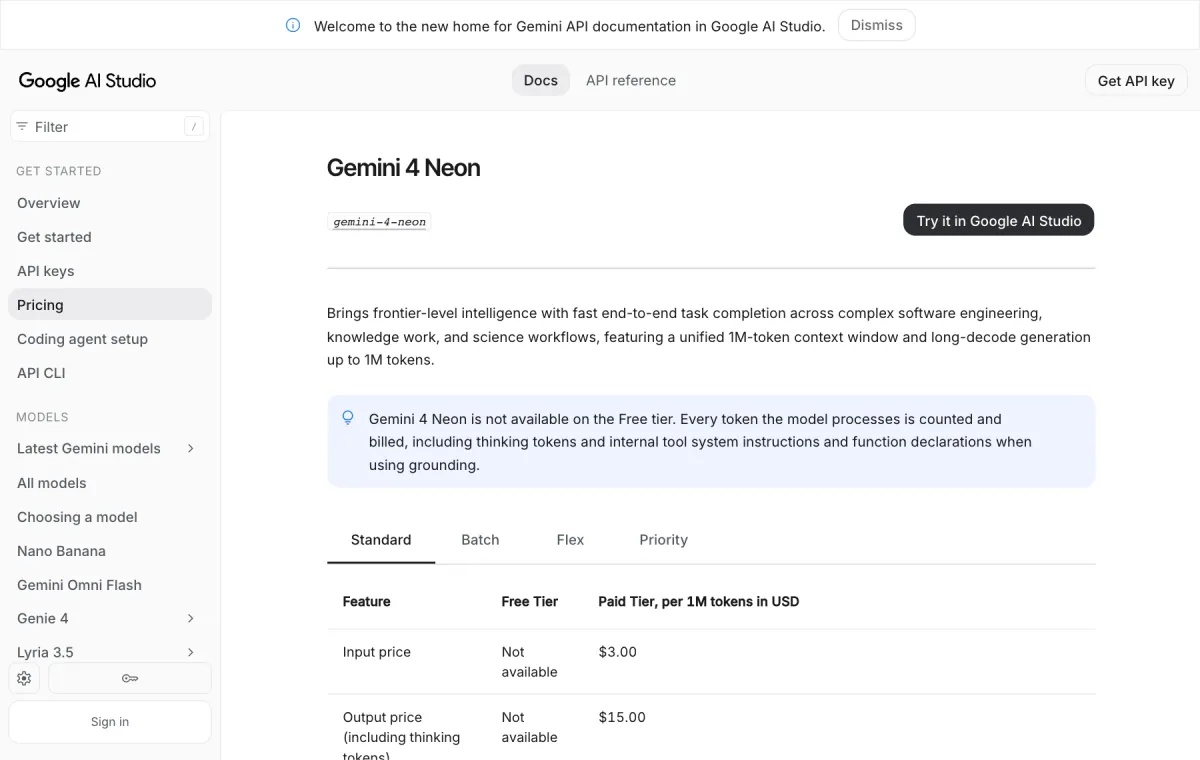
In der API gibt es keinen Free Tier für Neon: Die Preisseite führt jeden Free-Tier-Preis von Neon als „Not available“ (nicht verfügbar), genau wie bei Carbon. Hydrogen ist das Gemini-4-Modell, das du weiterhin kostenlos testen kannst. Googles Ankündigung nennt keine Länder. Ob in den USA, in Großbritannien oder am Golf: Prüf das Modell-Dropdown der Gemini-App mit einem Pro- oder Ultra-Abo oder mach einen Testaufruf aus einem kostenpflichtigen AI-Studio-Projekt. Was diese Abos in den VAE kosten, steht in unserem Ratgeber zu ChatGPT- und Gemini-Abos und ihren AED-Preisen in den VAE.
Was du brauchst
- Ein Google-Konto mit Zugang zu Google AI Studio.
- Ein Google-Cloud-Rechnungskonto, das mit deinem AI-Studio-Projekt verknüpft ist. Laut Googles Billing-Anleitung bedeutet der Wechsel in den Paid Tier, ein Rechnungskonto zu verknüpfen und im Prepay-Tarif mindestens 5 $ Guthaben vorauszuzahlen (manchen Konten wird stattdessen Postpay angeboten oder zugewiesen).
- Python mit
pip, Node.js mitnpmoder einfachcurl.
Gemini 4 Neon API einrichten: Schritt für Schritt
- API-Schlüssel holen. Öffne in AI Studio die Seite mit den API-Schlüsseln. Für neue Nutzer legt Google automatisch ein Projekt und einen Schlüssel an; sonst klickst du auf Create API key (API-Schlüssel erstellen) und folgst dem Dialog, um ein Schlüssel-Projekt-Paar anzulegen.
- Billing für das Projekt aktivieren. Such auf derselben Seite (oder auf der Seite Projects) das Projekt und klick in der Spalte Billing Tier auf Set up billing. Neue Billing-Nutzer wählen ein Land, akzeptieren die Bedingungen und hinterlegen eine Zahlungsmethode; bestehende Nutzer wählen ein Rechnungskonto. Zahl dann bei Bedarf die 5 $ Mindestbetrag im Voraus.
- Schlüssel als Umgebungsvariable speichern. Die SDKs lesen
GEMINI_API_KEYautomatisch aus. Unter macOS oder Linux:
export GEMINI_API_KEY="YOUR_API_KEY"- SDK installieren. Das sind die offiziellen Google-GenAI-Bibliotheken:
pip install -U google-genainpm install @google/genai- Erste Anfrage senden mit der Interactions API. In Python, aus der Neon-Doku:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)

print(interaction.output_text)
Die JavaScript-Version:
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

const interaction = await client.interactions.create({
  model: "gemini-4-neon",
  input: "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic.",
});

console.log(interaction.output_text);
Und der REST-Aufruf mit curl:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
}'- Kosten im Blick behalten. Die Nutzung siehst du in AI Studio unter Dashboard > Usage, und Googles Anleitung zu API-Schlüsseln empfiehlt, in der Google Cloud Console Budgetwarnungen einzurichten.
Der Umstieg von einem anderen Gemini-4-Modell „erfordert keine Änderungen am Request-Schema“, abgesehen von Modell-ID, Thinking-Level und einem kostenpflichtigen Projekt, so Googles Migrations-Checkliste. Unser Ratgeber zur Gemini 4 Hydrogen API erklärt die gemeinsame Einrichtung ausführlicher.

Thinking-Level bei Gemini 4 Neon: Welches du nehmen solltest
Das Thinking-Level ist dein wichtigster Hebel für Qualität, Latenz und Kosten. Neon unterstützt low, medium, high (Standard) und xhigh, aber nicht minimal, das Gemini 3.5 Flash-Lite und einige ältere Modelle nutzen. Googles Doku beschreibt die Level so:
| Level | Token-Verbrauch | Geeignet für |
|---|---|---|
low | Wenigste Tokens, niedrigste Latenz | Schneller Chat, Verarbeitung mit hohem Durchsatz; auch bei Agent-Aufgaben noch leistungsfähig |
medium | Geringerer Token-Verbrauch, schnellere Antworten | Interaktives Coding, Live-Prototyping von UIs, reaktionsschneller Chat, schnelle Tool-Aufrufe |
high (Standard) | Ausgewogen | Die meisten Aufgaben: komplexes Coding, Agents, Tool Calling, multimodale Wissensarbeit |
xhigh | Meiste Tokens, tiefstes Reasoning | Schwierige mehrstufige Engineering-, Analyse- und Wissenschaftsprobleme, bei denen high nicht reicht |
Gesetzt wird es über generation_config. Das ist Googles eigenes xhigh-Beispiel in Python:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh"
    }
)

print(interaction.output_text)
Bei REST steht dasselbe Feld im JSON-Body als "generation_config": {"thinking_level": "xhigh"}. Googles Rat: Lass deine Evaluierungen auf allen vier Levels mit einem hohen max_output_tokens laufen und wähl dann das niedrigste Level, das deine Qualitätsansprüche erfüllt. Thinking-Tokens werden als Output-Tokens abgerechnet, darum ist der Schritt von high auf medium oft günstiger als ein Modellwechsel. Mehr dazu im Thinking-Guide.
Schon gewusst?
Thinking-Tokens werden bei Neon als Output-Tokens abgerechnet. Der Wechsel vom Thinking-Level high auf medium ist deshalb oft günstiger als der Umstieg auf ein kleineres Modell.
Neon vs. Hydrogen vs. Carbon: Preistabelle und wann sich welches Modell lohnt
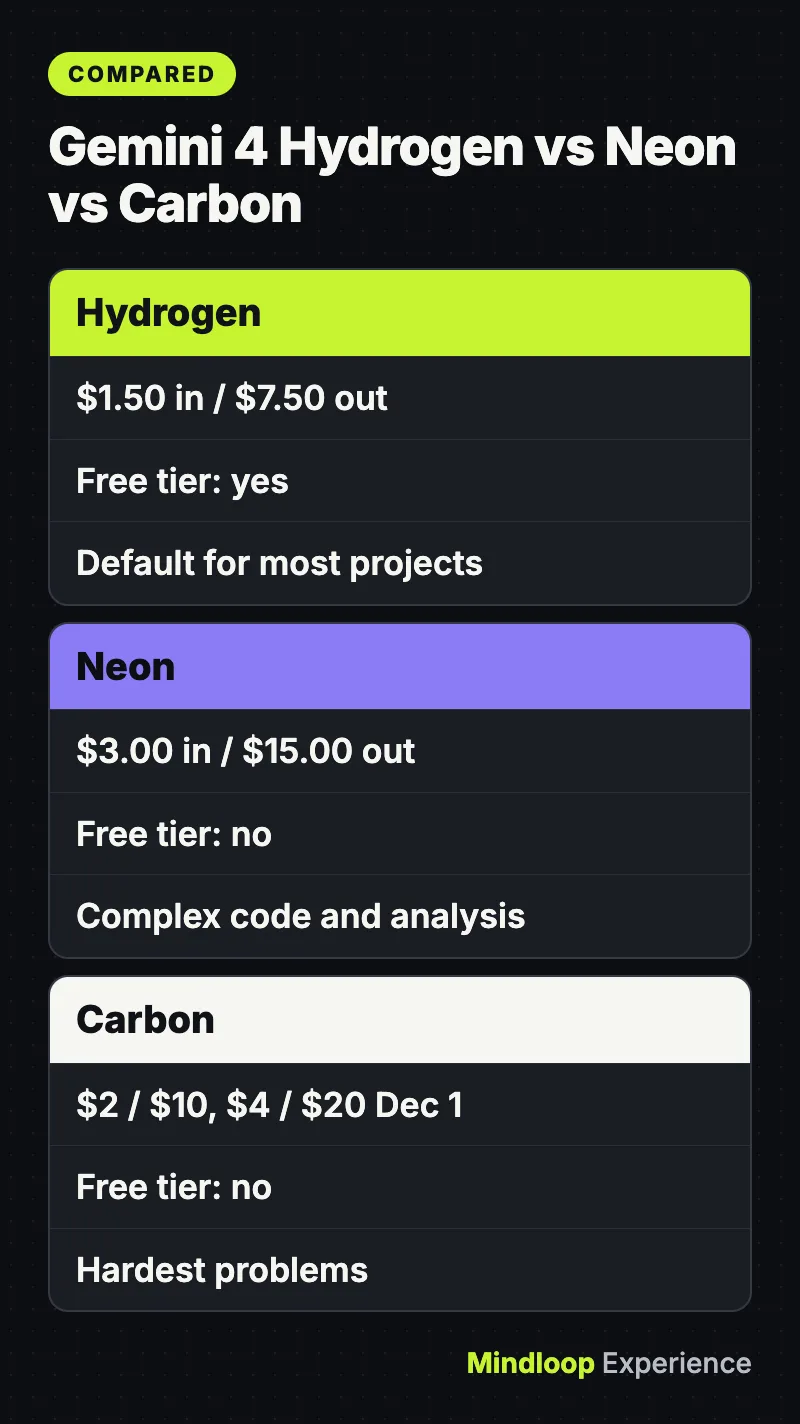
Standardpreise im Paid Tier pro 1 Million Tokens, laut Googles Preisseite, Stand 20. November 2026. Die Output-Preise enthalten Thinking-Tokens.
| Modell | Input | Output | Gecachter Input | Batch / Flex (In / Out) | Free Tier |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Ja |
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | Nein |
| Gemini 4 Carbon, bis 30. Nov. 2026 | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | Nein |
| Gemini 4 Carbon, ab 1. Dez. 2026 | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | Nein |
Gemini 4 Argon kostet dasselbe wie Carbon. Neons Priority Tier kostet 5,40 $ Input und 27,00 $ Output. Neons Preis ist über das gesamte 1-Mio.-Fenster gleich, und Googles Seite Choosing a model hält fest: „Neon has no introductory price“ (Neon hat keinen Einführungspreis). Bis zum 30. November ist Carbon also pro Token günstiger; ab dem 1. Dezember verdoppelt sich Carbon, und Neon wird das günstigere der beiden Modelle.
Googles eigene Empfehlung zur Auswahl:
- Hydrogen: der Standard für die meisten neuen Projekte, alltägliches Coding und parallele Worker-Agents, zum halben Preis von Neon.
- Neon: komplexes Software-Engineering, dichte Wissensarbeit und wissenschaftliche Workflows, „wo Hydrogen nicht reicht und du Carbons zusätzliche Verifizierung nicht brauchst“. Google nennt es außerdem als Upgrade für
gemini-3.1-pro-preview. - Carbon: deine schwierigsten Probleme wie Systemarchitektur, formale Beweise und Security-Audits, mit mehr Thinking-Tokens pro Runde. Mehr dazu in unserem Beitrag über Gemini 4 Carbon an der Spitze von MathArena.
Alle drei nutzen dasselbe Request-Schema. Mit previous_interaction_id kannst du ein Gespräch also von einem Modell an ein anderes übergeben, etwa Carbon zum Planen und Hydrogen zum Schreiben des Codes.
Kostenbeispiel: ein Agent-Lauf mit Standard vs. Batch
Angenommen, ein Agent-Lauf schickt 200.000 Input-Tokens (ein Code-Repository plus Anweisungen) und bekommt 20.000 Output-Tokens zurück, Thinking eingerechnet. Zu Googles Listenpreisen (die echten Token-Zahlen hängen von Aufgabe und Thinking-Level ab):
- Neon, Standard: 0,2 Mio. × 3,00 $ = 0,60 $ Input, plus 0,02 Mio. × 15,00 $ = 0,30 $ Output. Gesamt 0,90 $.
- Neon, Batch oder Flex: 0,2 Mio. × 1,50 $ = 0,30 $, plus 0,02 Mio. × 7,50 $ = 0,15 $. Gesamt 0,45 $.
- Neon, Priority: 0,2 Mio. × 5,40 $ = 1,08 $, plus 0,02 Mio. × 27,00 $ = 0,54 $. Gesamt 1,62 $.
- Neon, Standard, wenn 150.000 der Input-Tokens aus dem impliziten Cache kommen: 0,15 Mio. × 0,15 $ = 0,0225 $, plus 0,05 Mio. × 3,00 $ = 0,15 $, plus 0,30 $ Output. Gesamt etwa 0,47 $.
- Hydrogen, Standard: 0,30 $ + 0,15 $ = 0,45 $.
- Carbon, Standard: 0,40 $ + 0,20 $ = 0,60 $ bis zum 30. November, oder 0,80 $ + 0,40 $ = 1,20 $ ab dem 1. Dezember.
Bei 1.000 Läufen sind das 900 $ für Neon im Standard-Tarif gegenüber 450 $ mit Batch. Implizites Caching greift bei Prompts ab 4.096 Tokens und spart 95 % beim gecachten Input. Pack gemeinsame Anweisungen, Tool-Definitionen und Referenzdateien also an den Anfang. Ein Modell, das für dieselbe Aufgabe weniger Tokens braucht (Googles Aussage zu Neon im Vergleich mit Carbon), kostet pro erledigter Aufgabe weniger, als diese Rechnung zeigt.
Neue kostenpflichtige Konten haben außerdem Ausgabelimits. Die Seite zu den Rate Limits nennt für Tier 1 ein Ausgabe-Rate-Limit von 10 $ pro 10 Minuten (ob es gilt, hängt von deinem Konto ab). Das sind etwa 11 der Standard-Läufe von oben. Die Billing-Anleitung legt für Tier 1 eine monatliche Obergrenze von 250 $ fest.
Schon gewusst?
Implizites Caching läuft bei Prompts ab 4.096 Tokens automatisch und spart 95 % beim gecachten Input. Gecachter Neon-Input kostet dann nur 0,15 $ pro Million Tokens.
Häufige Fehler und Lösungen
- Neon funktioniert mit deinem Free-Tier-Schlüssel nicht. Im Free Tier wird es nicht angeboten. Klick auf der Seite mit den API-Schlüsseln oder unter Projects auf Set up billing. Zeigt das Projekt „Set up Prepay“ oder „No credits“, schließ die Prepay-Einrichtung ab oder lad Guthaben auf. Laut Billing-Anleitung beantwortet die API Paid-Tier-Anfragen nur, solange dein Prepay-Guthaben positiv ist.
thinking_level: "minimal"schlägt fehl. Neon lehntminimalmit einem Fehler ab. Nimm stattdessenlow.- Code für explizites Caching bricht. Neon unterstützt kein explizites Caching (
cachedContentsundcaches.create). Entfernecached_content-Felder und verlass dich auf implizites Caching. 400-Validierungsfehler nach der Migration. Entfernetemperature,top_pundtop_k. Werte im gültigen Bereich ignoriert der Server, Werte außerhalb davon liefern einen400-Fehler.- Antworten brechen zu früh ab.
max_output_tokensbegrenzt Thinking und Output zusammen. Entferne alte, niedrige Grenzen wie 8.192 oder heb die Grenze auf 65.536 an. Für längere Ausgaben setzt dubackgroundauftrueundmax_output_tokensüber 65.536 (zum Beispiel 131.072 oder 262.144). Mitbackground: true, aber ohnemax_output_tokensstoppt der Server nach 65.536 Tokens. Siehe Googles Long-Decode-Anleitung. MALFORMED_FUNCTION_CALL. Das kann passieren, wenn ein System-Prompt rohe JSON-Tool-Aufrufe verlangt, ohne dass Tools deklariert sind. Deklarier die Tools per Function Calling oder nutz Structured Outputs. Braucht dein Code nur ein Ja/Nein oder einen Score, zeigt unser Schnellstart zur Gemini Decisions API einen günstigeren Weg.429 RESOURCE_EXHAUSTED. Eine dokumentierte Ursache ist das Ausgabe-Rate-Limit. Warte und versuch es erneut oder schick kleinere Kontexte.- Anfragen laufen in einen Timeout. Laut Google können schwierige Prompts mehrere Minuten dauern. Nutz Background Execution oder setz die Timeouts deines HTTP-Clients auf mindestens 15 Minuten.
Fazit
Nimm Neon, wenn Hydrogen bei Code über mehrere Dateien, langen Dokumenten oder Analysen an Grenzen stößt und du Carbons zusätzliches Thinking nicht brauchst. Starte mit high, teste medium, heb dir xhigh für die härtesten Jobs auf und schick nicht dringende Arbeit zum halben Preis über Batch oder Flex. Zum bloßen Ausprobieren ist die Gemini-App mit Pro- oder Ultra-Abo am schnellsten, denn die API braucht ab dem ersten Aufruf Billing. Hydrogen bleibt der kostenlose Einstieg, und Google hat es auch in die Suche gebracht, wie wir in Google Search bekommt das Gemini-4-Hydrogen-Upgrade berichten. Weitere Anleitungen wie diese findest du in unserer Rubrik AI Guides.
Häufige Fragen
Ist Gemini 4 Neon kostenlos?
Nicht in der API. Googles Preisseite führt jeden Free-Tier-Preis von Neon als nicht verfügbar, du brauchst also ein kostenpflichtiges AI-Studio-Projekt mit verknüpftem Billing. Abonnenten von Google AI Pro und Ultra können Neon in der Gemini-App auswählen, und Hydrogen hat weiterhin einen Free Tier.
Wie lautet die Modell-ID von Gemini 4 Neon?
Die Modell-ID ist gemini-4-neon. Laut Googles Migrations-Checkliste braucht der Umstieg von einem anderen Gemini-4-Modell keine Änderungen am Request-Schema, abgesehen von Modell-ID, Thinking-Level und einem kostenpflichtigen Projekt.
Ist Gemini 4 Neon günstiger als Gemini 4 Carbon?
Pro Token nicht bis zum 30. November 2026: Carbon kostet bis dahin 2,00 $ und 10,00 $ pro Million Tokens, Neon 3,00 $ und 15,00 $. Ab dem 1. Dezember steigt Carbon auf 4,00 $ und 20,00 $. Google sagt außerdem, dass Neon beim Level high 32 % niedrigere Kosten pro Aufgabe als Carbon hat.
Unterstützt Gemini 4 Neon Context Caching?
Nur implizites Caching. Explizites Caching mit cachedContents und caches.create wird nicht unterstützt, entferne also cached_content-Felder. Implizites Caching greift bei Prompts ab 4.096 Tokens und senkt den Preis für gecachten Input um 95 % auf 0,15 $ pro Million Tokens.
Kurzes Quiz
Was ist das Standard-Thinking-Level von Gemini 4 Neon?
- medium
- high
- xhigh
Neon nutzt standardmäßig high und unterstützt außerdem low, medium und xhigh; minimal akzeptiert es nicht.
Was kostet ein Neon-Lauf mit 200.000 Input- und 20.000 Output-Tokens im Batch-Tarif?
- $0.45
- $0.90
- $1.62
Bei 1,50 $ Input und 7,50 $ Output pro Million Tokens sind es 0,30 $ plus 0,15 $, also 0,45 $.
Welches Thinking-Level lehnt Neon mit einem Fehler ab?
- low
- xhigh
- minimal
Neon unterstützt low, medium, high und xhigh und lehnt minimal ab, nimm also stattdessen low.
Quellen
Links zuletzt geprüft am 20. November 2026.
- What’s new in Gemini 4 Neon (Google AI Studio docs)
- Gemini 4 Neon model page (Google AI Studio docs)
- Gemini API pricing (Google AI Studio docs)
- Choosing a model (Google AI Studio docs)
- Billing (Google AI Studio docs)
- Rate limits (Google AI Studio docs)
- Gemini 4 Neon model card (Google DeepMind)
- Introducing Gemini 4 Neon (Google blog, November 18, 2026)


Kommentar schreiben