Google 于 2026 年 11 月 18 日发布了 Gemini 4 Neon:这是一款被 Google 定位在 Hydrogen 和 Carbon 之间的中端模型。按 Google 自己的测算,它的单任务成本低于 Carbon,但在 11 月 30 日之前,它的每 token 价格反而比 Carbon 更高。本文告诉你可以在哪里使用它、如何用 Python、JavaScript 或 curl 发出第一次 API 调用、该选哪个思考级别、一次智能体运行要花多少钱,以及把应用迁移过来时会遇到哪些报错。文中所有价格、限额和代码示例均来自 Google 官方文档,核查时间为 2026 年 11 月 20 日。
要点速览
- Gemini 4 Neon 介于 Hydrogen 和 Carbon 之间,每 100 万 token 输入 3.00 美元、输出 15.00 美元。
- 在 API 中,Neon 仅限付费层级;Pro 和 Ultra 订阅用户可以在 Gemini 应用中选择它。
- 它默认使用 high 思考级别,新增 xhigh,不支持 minimal;请选择能通过你测试的最低级别。
- 11 月 30 日之前 Carbon 的每 token 价格更便宜;从 12 月 1 日起,Carbon 涨价一倍,至 4.00 美元和 20.00 美元。
有什么新变化:一分钟了解 Gemini 4 Neon
Neon(模型 ID gemini-4-neon)是 Google Gemini 4 系列中新推出的中端模型。根据 What’s new in Gemini 4 Neon 页面,它“位于 Gemini 4 Hydrogen 和 Gemini 4 Carbon 之间,面向高频的复杂任务”,例如多文件重构、高密度文档和科研工作流。模型卡显示,Neon 由 Gemini 4 Carbon 改编而来,知识截止时间为 2026 年 3 月。
来自 Gemini 4 Neon 模型页面的基本信息:
- 输入:文本、图片、视频、音频和 PDF。输出:仅文本(不能生成图片或音频,不支持 Live API)。
- 上下文:一个 1,048,576 token 的统一窗口,由输入、思考和输出共享。
- 最大输出:同步响应默认每次 65,536 token,开启长解码后最高可达 1,048,576。
- 工具:函数调用、结构化输出、代码执行、computer use,以及 Search 和 Maps 接地(grounding)。
- 缓存:仅支持隐式缓存,不支持显式缓存。
Google 的发布公告引用了以下成绩(均为 Google 自己的数据):在 xhigh 思考级别下,Artificial Analysis Intelligence Index 得分 61(总排名第 3);Terminal-Bench 4.1 得分 65.2%;Vals Index 得分 70.9%。模型卡自己的表格显示,Claude Opus 5.5 在 Terminal-Bench 4.1 上略微领先(65.8%)。Google 还表示,在默认的 high 级别下,Neon“单任务成本比 Carbon 低 32%”。这是因为用的 token 更少而得出的单任务结论,并不是每 token 价格更低。
数据一览
1,048,576token 统一上下文窗口
65,536默认最大输出 token
$3.00每 100 万输入 token
在哪里可以使用 Gemini 4 Neon
根据 Google 的公告,Neon 正在以下渠道陆续上线:
| 渠道 | 适用对象 | 选择方式 |
|---|---|---|
| Gemini API(Google AI Studio) | 仅限付费层级的开发者 | model: "gemini-4-neon" |
| Gemini 应用 | Google AI Pro 和 Ultra 订阅用户 | 模型下拉菜单 |
| Google AI Studio | Google AI Pro 和 Ultra 订阅用户 | 公告中未说明 |
| Google Antigravity | 付费的 Google AI Pro 和 Ultra 订阅用户 | 公告中未说明 |
| Gemini 企业版 | 企业客户 | API 或模型下拉菜单 |
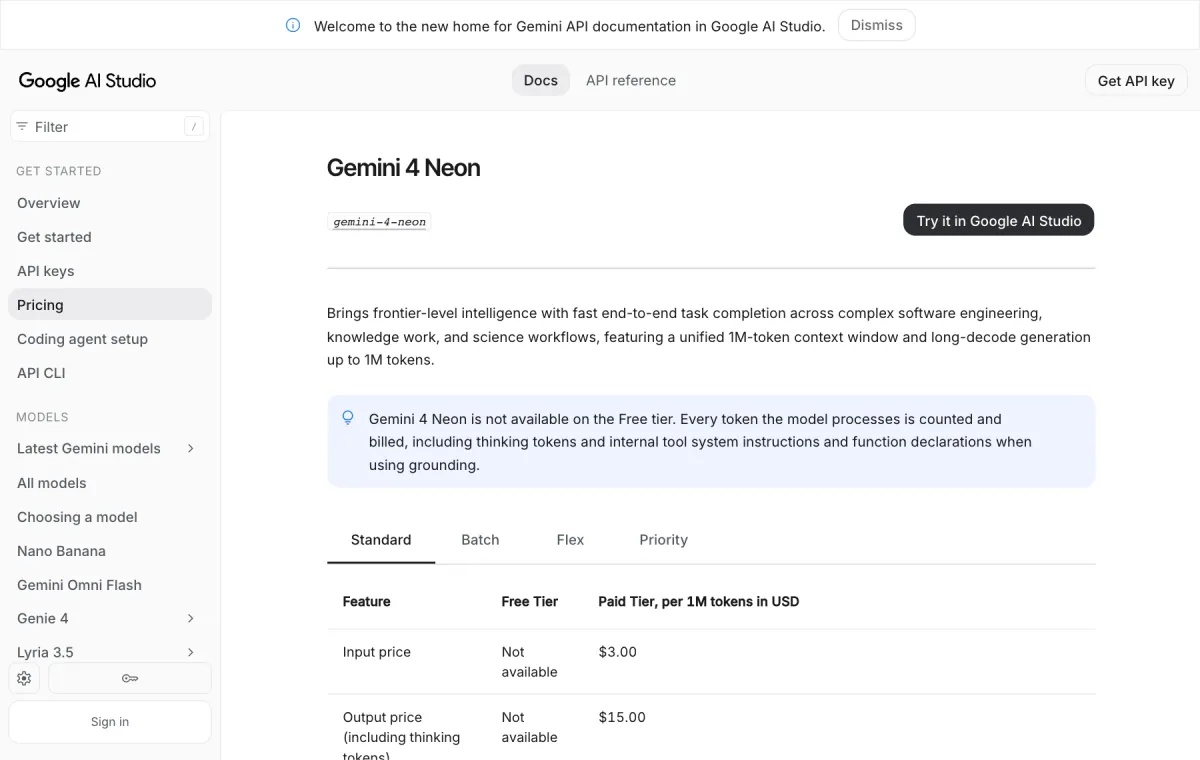
API 没有为 Neon 提供免费层级:价格页面把 Neon 的所有免费层级价格都标为“Not available”(不可用),和 Carbon 一样。Hydrogen 是目前仍可免费试用的 Gemini 4 模型。Google 的公告没有列出具体国家,所以如果你在美国、英国或海湾地区,可以在 Pro 或 Ultra 套餐下查看 Gemini 应用的模型下拉菜单,或者从付费的 AI Studio 项目发起一次测试调用。想了解这些套餐在阿联酋的价格,请看我们的 ChatGPT 和 Gemini 套餐及阿联酋迪拉姆价格指南。
准备工作
- 一个可以访问 Google AI Studio 的 Google 账号。
- 一个关联到 AI Studio 项目的 Google Cloud 结算账号。Google 的结算指南说明,升级到付费层级需要关联结算账号,并在 Prepay(预付)方案下预付至少 5 美元的额度(部分账号会被提供或分配 Postpay 后付方案)。
- 装有
pip的 Python,或装有npm的 Node.js,或者只用curl。
Gemini 4 Neon API 设置分步教程
- 获取 API 密钥。打开 AI Studio 的 API 密钥页面。对于新用户,Google 会自动创建项目和密钥;否则点击 Create API key(创建 API 密钥),按对话框提示添加一组密钥和项目。
- 为该项目开启结算。在同一个 API 密钥页面(或 Projects 页面)找到项目,在 Billing Tier 列下点击 Set up billing(设置结算)。新的结算用户需要选择国家、接受条款并添加付款方式;已有用户则选择一个结算账号。如有提示,再预付最低 5 美元。
- 把密钥存为环境变量。SDK 会自动读取
GEMINI_API_KEY。在 macOS 或 Linux 上:
export GEMINI_API_KEY="YOUR_API_KEY"- 安装 SDK。以下是官方的 Google GenAI 库:
pip install -U google-genainpm install @google/genai- 使用 Interactions API 发送第一个请求。以下是 Neon 文档中的 Python 示例:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)

print(interaction.output_text)
JavaScript 版本:
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

const interaction = await client.interactions.create({
  model: "gemini-4-neon",
  input: "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic.",
});

console.log(interaction.output_text);
以及用 curl 发起的 REST 调用:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
}'- 留意花费。用量显示在 AI Studio 的 Dashboard > Usage 下,Google 的 API 密钥指南建议在 Google Cloud 控制台中设置结算提醒。
根据 Google 的迁移清单,从其他 Gemini 4 模型切换过来,除了模型 ID、思考级别和付费项目之外,“无需更改请求结构”。我们的 Gemini 4 Hydrogen API 指南对通用设置有更深入的介绍。

Gemini 4 Neon 思考级别:该用哪一个
思考级别是你调节质量、延迟和成本的主要手段。Neon 支持 low、medium、high(默认)和 xhigh,但不支持 Gemini 3.5 Flash-Lite 和一些旧模型使用的 minimal。Google 文档是这样描述它们的:
| 级别 | token 用量 | 适用场景 |
|---|---|---|
low | token 最少,延迟最低 | 快速聊天、高吞吐量处理;在智能体任务上依然能胜任 |
medium | token 用量较低,响应更快 | 交互式编程、实时 UI 原型、即时聊天、快速工具调用 |
high(默认) | 均衡 | 大多数任务:复杂编程、智能体、工具调用、多模态知识工作 |
xhigh | token 最多,推理最深入 | 困难的多步骤工程、分析和科学问题,即 high 不够用的场景 |
通过 generation_config 进行设置。以下是 Google 官方的 Python xhigh 示例:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh"
    }
)

print(interaction.output_text)
在 REST 中,同一字段放在 JSON 请求体里,写作 "generation_config": {"thinking_level": "xhigh"}。Google 的建议是:在较高的 max_output_tokens 下,用全部四个级别运行你的评测,然后选出达到质量标准的最低级别。思考 token 按输出 token 计费,所以从 high 降到 medium,往往比换模型更省钱。更多内容见思考指南。
你知道吗?
在 Neon 上,思考 token 按输出 token 计费,所以把思考级别从 high 降到 medium,往往比换用更小的模型更省钱。
Neon、Hydrogen 与 Carbon:价格表及各自适用场景
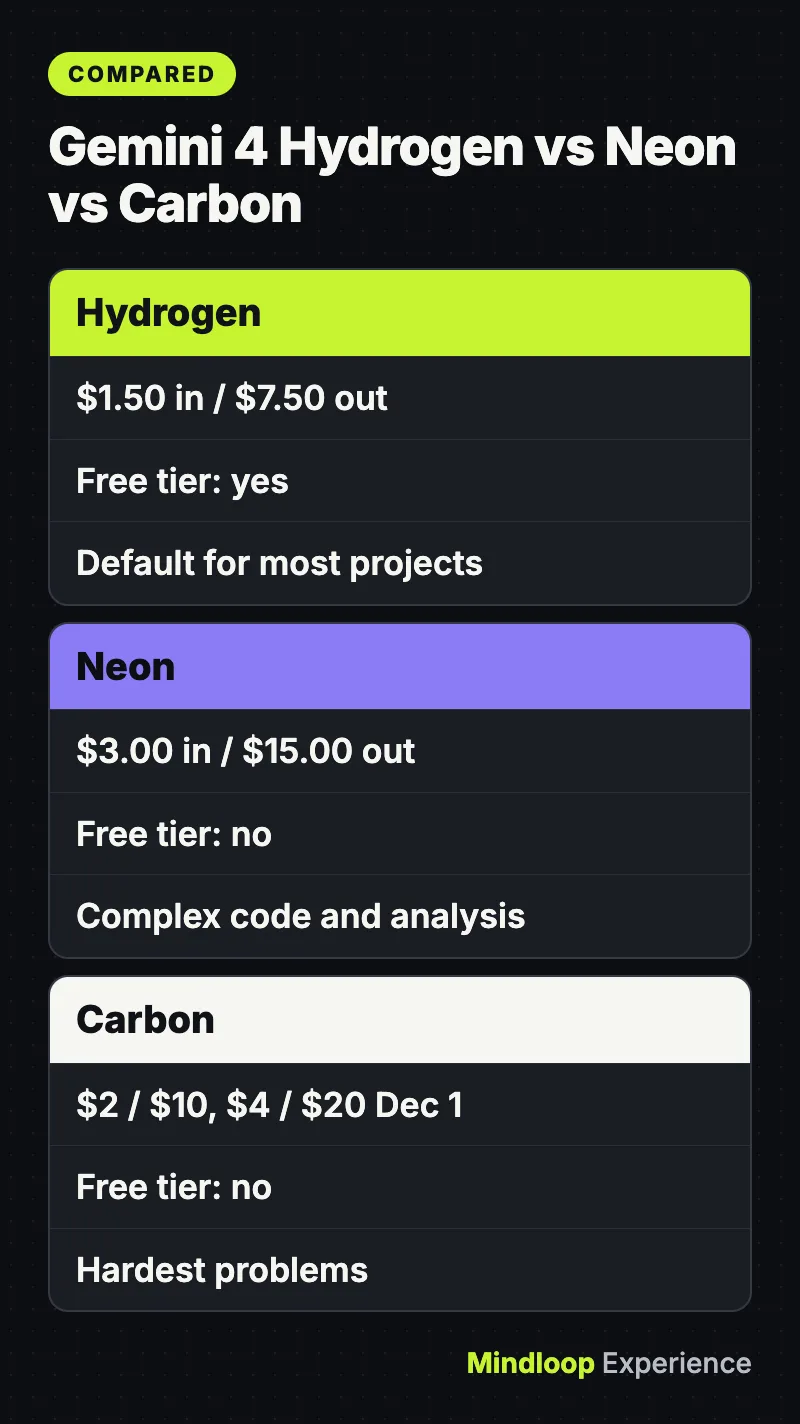
以下为每 100 万 token 的标准付费层级价格,数据来自 Google 价格页面,截至 2026 年 11 月 20 日。输出价格包含思考 token。
| 模型 | 输入 | 输出 | 缓存输入 | Batch / Flex(输入 / 输出) | 免费层级 |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | 有 |
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | 无 |
| Gemini 4 Carbon,截至 2026 年 11 月 30 日 | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | 无 |
| Gemini 4 Carbon,2026 年 12 月 1 日起 | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | 无 |
Gemini 4 Argon 的价格与 Carbon 相同。Neon 的 Priority 层级价格为输入 5.40 美元、输出 27.00 美元。Neon 的价格在整个 100 万 token 窗口内保持统一,Google 的 Choosing a model 页面还指出“Neon 没有首发优惠价”。因此在 11 月 30 日之前,Carbon 的每 token 价格更便宜;从 12 月 1 日起 Carbon 价格翻倍,Neon 就成了两者中更便宜的那个。
Google 官方的选择建议:
- Hydrogen:大多数新项目、日常编程和并行工作智能体的默认选择,价格只有 Neon 的一半。
- Neon:复杂软件工程、高密度知识工作和科研工作流,适用于“Hydrogen 不够用、又不需要 Carbon 额外验证”的场景。Google 还把它列为
gemini-3.1-pro-preview的升级选项。 - Carbon:用于你最难的问题,例如系统架构、形式化证明和安全审计,每轮会消耗更多思考 token。可参阅我们的文章 Gemini 4 Carbon 登顶 MathArena。
三者共用同一种请求结构,因此你可以传入 previous_interaction_id,把对话从一个模型交接给另一个模型,例如用 Carbon 做规划,再用 Hydrogen 写代码。
成本测算示例:一次智能体运行,high 标准价与 Batch 对比
假设一次智能体运行发送 200,000 个输入 token(一个代码仓库加上指令),返回 20,000 个输出 token(含思考)。按 Google 的标价计算(实际 token 数取决于任务和思考级别):
- Neon,Standard:0.2M × $3.00 = $0.60 输入,加上 0.02M × $15.00 = $0.30 输出。合计 $0.90。
- Neon,Batch 或 Flex:0.2M × $1.50 = $0.30,加上 0.02M × $7.50 = $0.15。合计 $0.45。
- Neon,Priority:0.2M × $5.40 = $1.08,加上 0.02M × $27.00 = $0.54。合计 $1.62。
- Neon,Standard,其中 150,000 个输入 token 命中隐式缓存:0.15M × $0.15 = $0.0225,加上 0.05M × $3.00 = $0.15,再加 $0.30 输出。合计约 $0.47。
- Hydrogen,Standard:$0.30 + $0.15 = $0.45。
- Carbon,Standard:11 月 30 日前为 $0.40 + $0.20 = $0.60,12 月 1 日起为 $0.80 + $0.40 = $1.20。
如果运行 1,000 次,Neon 在 Standard 下要花 900 美元,而 Batch 只需 450 美元。隐式缓存对至少 4,096 token 的提示生效,缓存输入可享 95% 的折扣,所以请把共享的指令、工具定义和参考文件放在最前面。如果一个模型完成同样任务需要的 token 更少(这正是 Google 对 Neon 相比 Carbon 的说法),那么它每完成一个任务的成本会比上面的计算更低。
新的付费账号还有花费限额。速率限制页面列出 Tier 1 的花费速率上限为每 10 分钟 10 美元(是否适用取决于你的账号),大约相当于上面 11 次 Standard 运行。结算指南还为 Tier 1 设定了每月 250 美元的上限。
你知道吗?
隐式缓存会自动作用于至少 4,096 token 的提示,缓存输入可享 95% 折扣,使 Neon 的缓存输入价格降至每百万 token 0.15 美元。
常见错误及解决方法
- Neon 在免费层级密钥上无法使用。免费层级不提供 Neon。在 API 密钥或 Projects 页面点击 Set up billing。如果项目显示“Set up Prepay”或“No credits”,请完成预付设置或充值额度。结算指南说明,只有在你的预付余额为正时,API 才会处理付费层级请求。
thinking_level: "minimal"报错。Neon 会拒绝minimal并返回错误。请改用low。- 显式缓存代码失效。Neon 不支持显式缓存(
cachedContents和caches.create)。请删除cached_content字段,改用隐式缓存。 - 迁移后出现
400校验错误。删除temperature、top_p和top_k。服务器会忽略范围内的值,但超出范围的值会返回400错误。 - 回答提前中断。
max_output_tokens限制的是思考和输出的总和。请删除以前设置的较低上限(例如 8,192),或把上限提高到 65,536。如需更长的输出,把background设为true,并把max_output_tokens设到 65,536 以上(例如 131,072 或 262,144)。如果设置了background: true却没有设置max_output_tokens,服务器会在 65,536 token 后停止。参见 Google 的长解码指南。 MALFORMED_FUNCTION_CALL。当系统提示要求输出原始 JSON 工具调用、却没有声明任何工具时,可能出现这个错误。请通过函数调用声明工具,或使用结构化输出。如果你的代码只需要一个是/否或一个分数,我们的 Gemini Decisions API 快速入门介绍了一种更便宜的做法。429 RESOURCE_EXHAUSTED。文档记载的原因之一是花费速率限制。请稍候重试,或发送更小的上下文。- 请求超时。Google 表示,困难的提示可能需要几分钟。请使用后台执行,或把 HTTP 客户端超时设为至少 15 分钟。
总结
当 Hydrogen 在多文件代码、长文档或分析任务上力不从心,而你又不需要 Carbon 额外的思考能力时,就用 Neon。从 high 开始,测试一下 medium,把 xhigh 留给最难的任务,不着急的工作走 Batch 或 Flex,享受半价。如果只是想试试,用 Pro 或 Ultra 套餐的 Gemini 应用最快,因为 API 从第一次调用起就需要开通结算。Hydrogen 依然是免费的入门选择,Google 也已经把它带到了搜索中,详见 Google 搜索升级 Gemini 4 Hydrogen。更多类似指南请看我们的 AI 指南栏目。
常见问题
Gemini 4 Neon 可以免费使用吗?
在 API 中不行。Google 价格页面把 Neon 的所有免费层级价格都列为不可用,所以你需要一个已关联结算的付费 AI Studio 项目。Google AI Pro 和 Ultra 订阅用户可以在 Gemini 应用中选择 Neon,而 Hydrogen 仍有免费层级。
Gemini 4 Neon 的模型 ID 是什么?
模型 ID 是 gemini-4-neon。Google 的迁移清单表示,从其他 Gemini 4 模型切换过来,除了模型 ID、思考级别和付费项目之外,无需更改请求结构。
Gemini 4 Neon 比 Gemini 4 Carbon 便宜吗?
截至 2026 年 11 月 30 日,按每 token 计算并不便宜:届时 Carbon 为每百万 token 2.00 美元和 10.00 美元,而 Neon 为 3.00 美元和 15.00 美元。从 12 月 1 日起,Carbon 涨到 4.00 美元和 20.00 美元。Google 还表示,在 high 级别下,Neon 的单任务成本比 Carbon 低 32%。
Gemini 4 Neon 支持上下文缓存吗?
只支持隐式缓存。不支持使用 cachedContents 和 caches.create 的显式缓存,所以请删除 cached_content 字段。隐式缓存对至少 4,096 token 的提示生效,缓存输入享 95% 折扣,即每百万 token 0.15 美元。
小测验
Gemini 4 Neon 的默认思考级别是什么?
- medium
- high
- xhigh
Neon 默认使用 high,还支持 low、medium 和 xhigh;它不接受 minimal。
一次输入 20 万、输出 2 万 token 的 Neon 运行,在 Batch 层级下要花多少钱?
- $0.45
- $0.90
- $1.62
按每百万 token 输入 1.50 美元、输出 7.50 美元计算,就是 0.30 美元加 0.15 美元,共 0.45 美元。
Neon 会拒绝哪个思考级别并报错?
- low
- xhigh
- minimal
Neon 支持 low、medium、high 和 xhigh,会拒绝 minimal,所以请改用 low。
资料来源
链接最后核查时间:2026 年 11 月 20 日。
- What’s new in Gemini 4 Neon (Google AI Studio docs)
- Gemini 4 Neon model page (Google AI Studio docs)
- Gemini API pricing (Google AI Studio docs)
- Choosing a model (Google AI Studio docs)
- Billing (Google AI Studio docs)
- Rate limits (Google AI Studio docs)
- Gemini 4 Neon model card (Google DeepMind)
- Introducing Gemini 4 Neon (Google blog, November 18, 2026)


写评论