Google a lancé Gemini 4 Neon le 18 novembre 2026 : un modèle intermédiaire que Google place entre Hydrogen et Carbon, avec un coût par tâche inférieur à celui de Carbon selon les propres mesures de Google, mais un prix par token plus élevé que Carbon jusqu’au 30 novembre. Voici où l’utiliser, comment faire votre premier appel API en Python, JavaScript ou curl, quel niveau de réflexion choisir, ce que coûte une exécution d’agent et les erreurs que vous rencontrerez en migrant une application. Chaque prix, limite et exemple de code provient de la documentation officielle de Google, vérifiée le 20 novembre 2026.
L’essentiel
- Gemini 4 Neon se situe entre Hydrogen et Carbon et coûte 3,00 $ en entrée et 15,00 $ en sortie par million de tokens.
- Dans l’API, Neon est réservé au niveau payant ; les abonnés Pro et Ultra peuvent le choisir dans l’application Gemini.
- Il utilise par défaut le niveau de réflexion high, ajoute xhigh et refuse minimal ; choisissez le niveau le plus bas qui réussit vos tests.
- Jusqu’au 30 novembre, Carbon est moins cher par token ; à partir du 1er décembre, Carbon double à 4,00 $ et 20,00 $.
Les nouveautés : Gemini 4 Neon en une minute
Neon (ID de modèle gemini-4-neon) est le nouveau modèle intermédiaire de Google dans la famille Gemini 4. Selon la page What’s new in Gemini 4 Neon, il « se situe entre Gemini 4 Hydrogen et Gemini 4 Carbon pour les tâches complexes à haute fréquence », comme la refactorisation multifichier, les documents denses et les workflows scientifiques. La fiche du modèle indique que Neon est dérivé de Gemini 4 Carbon et que ses connaissances s’arrêtent à mars 2026.
L’essentiel, d’après la page du modèle Gemini 4 Neon :
- Entrées : texte, image, vidéo, audio et PDF. Sortie : texte uniquement (pas de génération d’image ou d’audio, pas de Live API).
- Contexte : une fenêtre unifiée de 1 048 576 tokens partagée entre l’entrée, la réflexion et la sortie.
- Sortie maximale : 65 536 tokens par réponse synchrone par défaut, jusqu’à 1 048 576 avec le long decode.
- Outils : appel de fonctions, sorties structurées, exécution de code, computer use, ancrage via Search et Maps.
- Mise en cache : cache implicite uniquement. Le cache explicite n’est pas pris en charge.
L’annonce de Google cite ces résultats (chiffres de Google) : un score de 61 sur l’Artificial Analysis Intelligence Index au niveau de réflexion xhigh (3e au classement général), 65,2 % sur Terminal-Bench 4.1 et 70,9 % sur le Vals Index. Le tableau de la fiche du modèle montre toutefois Claude Opus 5.5 légèrement devant sur Terminal-Bench 4.1 (65,8 %). Google affirme aussi qu’au niveau high par défaut, Neon offre « un coût par tâche inférieur de 32 % à celui de Carbon ». Il s’agit d’un gain par tâche, obtenu en consommant moins de tokens, et non d’un prix par token plus bas.
En chiffres
1 048 576tokens de fenêtre de contexte unifiée
65 536tokens de sortie maximale par défaut
3,00 $par million de tokens en entrée
Où utiliser Gemini 4 Neon
Selon l’annonce de Google, Neon est en cours de déploiement ici :
| Où | Pour qui | Comment le choisir |
|---|---|---|
| Gemini API (Google AI Studio) | Développeurs au niveau payant uniquement | model: "gemini-4-neon" |
| Application Gemini | Abonnés Google AI Pro et Ultra | Menu déroulant des modèles |
| Google AI Studio | Abonnés Google AI Pro et Ultra | Non précisé dans l’annonce |
| Google Antigravity | Abonnés payants Google AI Pro et Ultra | Non précisé dans l’annonce |
| Gemini pour les entreprises | Clients professionnels | API ou menu déroulant des modèles |
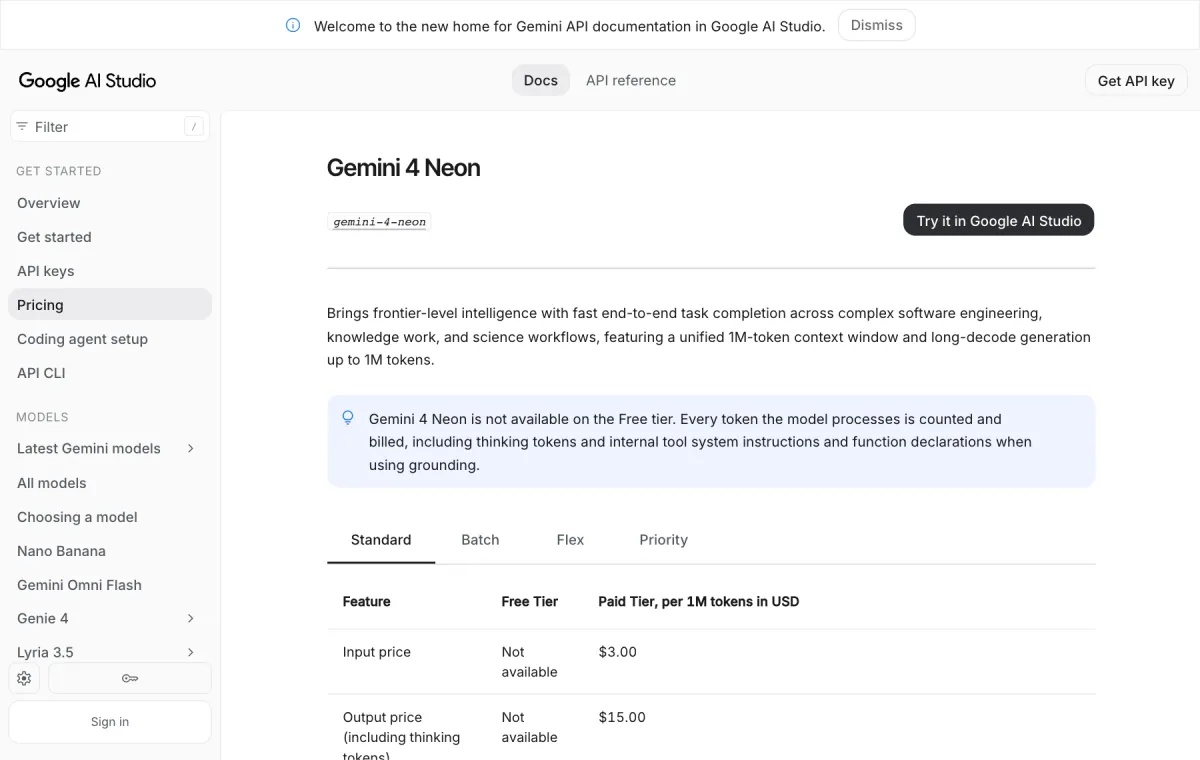
L’API n’a aucune offre gratuite pour Neon : la page des tarifs indique « Not available » (non disponible) pour chaque prix gratuit de Neon, comme pour Carbon. Hydrogen est le modèle Gemini 4 que vous pouvez encore essayer gratuitement. L’annonce de Google ne liste aucun pays : aux États-Unis, au Royaume-Uni ou dans le Golfe, vérifiez le menu déroulant des modèles de l’application Gemini avec un forfait Pro ou Ultra, ou faites un appel de test depuis un projet AI Studio payant. Pour le prix de ces forfaits aux Émirats, consultez notre guide sur les forfaits ChatGPT et Gemini et leurs prix en AED aux Émirats arabes unis.
Ce qu’il vous faut
- Un compte Google avec accès à Google AI Studio.
- Un compte de facturation Google Cloud associé à votre projet AI Studio. Le guide de facturation de Google précise que passer au niveau payant implique d’associer un compte de facturation et de prépayer au moins 5 $ de crédits avec le forfait Prepay (certains comptes se voient proposer ou attribuer le Postpay à la place).
- Python avec
pip, ou Node.js avecnpm, ou simplementcurl.
Configurer l’API Gemini 4 Neon, étape par étape
- Obtenez une clé API. Ouvrez la page des clés API d’AI Studio. Google crée automatiquement un projet et une clé pour les nouveaux utilisateurs ; sinon, cliquez sur Create API key (Créer une clé API) et suivez la boîte de dialogue pour ajouter une paire clé-projet.
- Activez la facturation pour ce projet. Sur la même page des clés API (ou la page Projects), trouvez le projet et cliquez sur Set up billing (Configurer la facturation) dans la colonne Billing Tier. Les nouveaux utilisateurs de la facturation choisissent un pays, acceptent les conditions et ajoutent un moyen de paiement ; les utilisateurs existants choisissent un compte de facturation. Prépayez ensuite le minimum de 5 $ si on vous le demande.
- Enregistrez la clé dans une variable d’environnement. Les SDK récupèrent
GEMINI_API_KEYautomatiquement. Sous macOS ou Linux :
export GEMINI_API_KEY="YOUR_API_KEY"- Installez le SDK. Voici les bibliothèques Google GenAI officielles :
pip install -U google-genainpm install @google/genai- Envoyez votre première requête avec l’Interactions API. En Python, d’après la documentation de Neon :
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)

print(interaction.output_text)
La version JavaScript :
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

const interaction = await client.interactions.create({
  model: "gemini-4-neon",
  input: "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic.",
});

console.log(interaction.output_text);
Et l’appel REST avec curl :
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
}'- Surveillez vos dépenses. La consommation apparaît dans AI Studio sous Dashboard > Usage, et le guide des clés API de Google recommande de configurer des alertes de facturation dans la console Google Cloud.
Passer d’un autre modèle Gemini 4 « ne nécessite aucune modification du schéma des requêtes » au-delà de l’ID du modèle, du niveau de réflexion et d’un projet payant, selon la checklist de migration de Google. Notre guide de l’API Gemini 4 Hydrogen détaille plus en profondeur la configuration commune.

Niveaux de réflexion de Gemini 4 Neon : lequel choisir
Le niveau de réflexion est votre principal levier sur la qualité, la latence et le coût. Neon prend en charge low, medium, high (par défaut) et xhigh, mais pas minimal, utilisé par Gemini 3.5 Flash-Lite et certains modèles plus anciens. La documentation de Google les décrit ainsi :
| Niveau | Consommation de tokens | Idéal pour |
|---|---|---|
low | Le moins de tokens, la latence la plus faible | Chat rapide, traitement à haut débit ; reste performant sur les tâches agentiques |
medium | Moins de tokens, réponses plus rapides | Code interactif, prototypage d’interface en direct, chat réactif, appels d’outils rapides |
high (par défaut) | Équilibré | La plupart des tâches : code complexe, agents, appels d’outils, travail de connaissance multimodal |
xhigh | Le plus de tokens, le raisonnement le plus poussé | Ingénierie complexe en plusieurs étapes, problèmes analytiques et scientifiques où high ne suffit pas |
Réglez-le via generation_config. Voici l’exemple xhigh de Google en Python :
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh"
    }
)

print(interaction.output_text)
En REST, le même champ se place dans le corps JSON sous la forme "generation_config": {"thinking_level": "xhigh"}. Le conseil de Google : lancez vos évaluations aux quatre niveaux avec un max_output_tokens élevé, puis choisissez le niveau le plus bas qui atteint votre exigence de qualité. Les tokens de réflexion sont facturés comme des tokens de sortie : passer de high à medium est donc souvent une solution moins chère que de changer de modèle. Le guide sur la réflexion en dit plus.
Le saviez-vous ?
Sur Neon, les tokens de réflexion sont facturés comme des tokens de sortie : passer du niveau de réflexion high à medium coûte donc souvent moins cher que de passer à un modèle plus petit.
Neon, Hydrogen ou Carbon : tableau des prix et quand choisir chacun
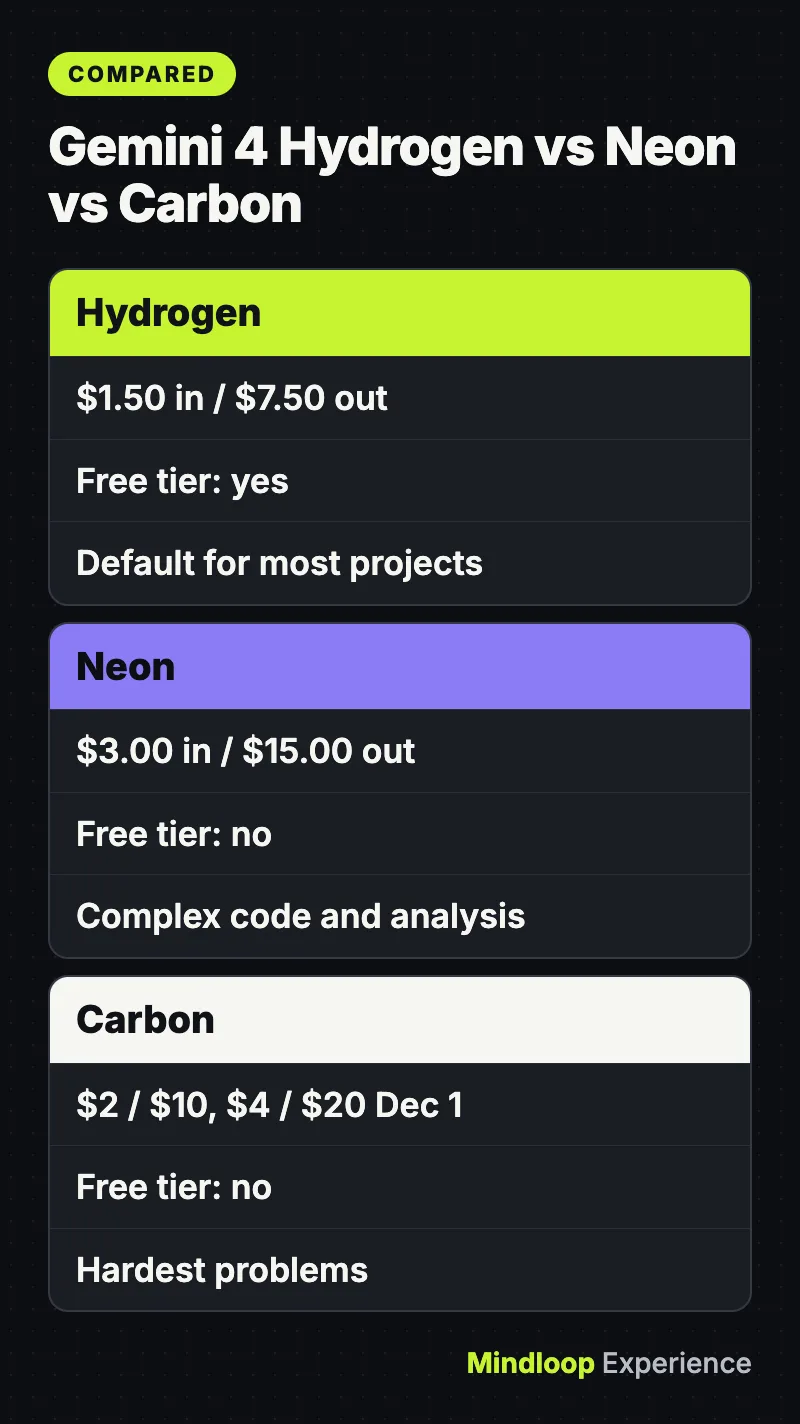
Prix standard du niveau payant par million de tokens, d’après la page des tarifs de Google au 20 novembre 2026. Les prix de sortie incluent les tokens de réflexion.
| Modèle | Entrée | Sortie | Entrée en cache | Batch / Flex (entrée / sortie) | Offre gratuite |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Oui |
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | Non |
| Gemini 4 Carbon, jusqu’au 30 nov. 2026 | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | Non |
| Gemini 4 Carbon, à partir du 1er déc. 2026 | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | Non |
Gemini 4 Argon a les mêmes prix que Carbon. Le niveau Priority de Neon coûte 5,40 $ en entrée et 27,00 $ en sortie. Le prix de Neon est le même sur toute la fenêtre de 1M, et la page Choosing a model de Google précise que « Neon has no introductory price » (Neon n’a pas de prix de lancement). Jusqu’au 30 novembre, Carbon est donc moins cher par token ; à partir du 1er décembre, Carbon double et Neon devient le moins cher des deux.
Les recommandations de Google pour choisir :
- Hydrogen : le choix par défaut pour la plupart des nouveaux projets, le code du quotidien et les agents travailleurs en parallèle, à la moitié du prix de Neon.
- Neon : ingénierie logicielle complexe, travail de connaissance dense et workflows scientifiques « quand Hydrogen ne suffit pas et que vous n’avez pas besoin de la vérification supplémentaire de Carbon ». Google le présente aussi comme la mise à niveau de
gemini-3.1-pro-preview. - Carbon : vos problèmes les plus difficiles, comme l’architecture système, les preuves formelles et les audits de sécurité, avec plus de tokens de réflexion par tour. Lisez notre article sur Gemini 4 Carbon en tête de MathArena.
Les trois partagent le même schéma de requête : vous pouvez donc passer previous_interaction_id pour transmettre une conversation d’un modèle à un autre, par exemple Carbon pour planifier et Hydrogen pour écrire le code.
Exemple de coût : une exécution d’agent en Standard ou en Batch
Imaginons qu’une exécution d’agent envoie 200 000 tokens en entrée (un dépôt de code et des instructions) et reçoive 20 000 tokens en sortie, réflexion comprise. Aux prix catalogue de Google (le nombre réel de tokens dépend de la tâche et du niveau de réflexion) :
- Neon, Standard : 0,2M × 3,00 $ = 0,60 $ en entrée, plus 0,02M × 15,00 $ = 0,30 $ en sortie. Total 0,90 $.
- Neon, Batch ou Flex : 0,2M × 1,50 $ = 0,30 $, plus 0,02M × 7,50 $ = 0,15 $. Total 0,45 $.
- Neon, Priority : 0,2M × 5,40 $ = 1,08 $, plus 0,02M × 27,00 $ = 0,54 $. Total 1,62 $.
- Neon, Standard, avec 150 000 des tokens d’entrée servis par le cache implicite : 0,15M × 0,15 $ = 0,0225 $, plus 0,05M × 3,00 $ = 0,15 $, plus 0,30 $ en sortie. Total environ 0,47 $.
- Hydrogen, Standard : 0,30 $ + 0,15 $ = 0,45 $.
- Carbon, Standard : 0,40 $ + 0,20 $ = 0,60 $ jusqu’au 30 novembre, ou 0,80 $ + 0,40 $ = 1,20 $ à partir du 1er décembre.
Sur 1 000 exécutions, cela fait 900 $ pour Neon en Standard contre 450 $ en Batch. Le cache implicite s’active sur les prompts d’au moins 4 096 tokens et retire 95 % du prix de l’entrée en cache : placez donc en premier les instructions partagées, les définitions d’outils et les fichiers de référence. Un modèle qui consomme moins de tokens pour la même tâche, ce que Google affirme pour Neon face à Carbon, coûte moins cher par tâche terminée que ne le montre ce calcul.
Les nouveaux comptes payants ont aussi des plafonds de dépenses. La page des limites de débit indique une limite de dépenses de 10 $ par tranche de 10 minutes pour le Tier 1 (son application dépend de votre compte), soit environ 11 des exécutions Standard ci-dessus. Le guide de facturation fixe un plafond mensuel de 250 $ pour le Tier 1.
Le saviez-vous ?
Le cache implicite s’active automatiquement sur les prompts d’au moins 4 096 tokens et retire 95 % du prix de l’entrée en cache, ce qui ramène l’entrée en cache de Neon à 0,15 $ par million de tokens.
Erreurs courantes et solutions
- Neon ne fonctionne pas avec votre clé gratuite. Il n’est pas proposé au niveau gratuit. Cliquez sur Set up billing sur la page des clés API ou des projets. Si le projet affiche « Set up Prepay » ou « No credits », terminez la configuration du Prepay ou ajoutez des crédits. Le guide de facturation précise que l’API ne traite les requêtes payantes que tant que votre solde Prepay est positif.
thinking_level: "minimal"échoue. Neon refuseminimalavec une erreur. Utilisezlowà la place.- Le code de cache explicite ne marche plus. Neon ne prend pas en charge le cache explicite (
cachedContentsetcaches.create). Supprimez les champscached_contentet comptez sur le cache implicite. - Erreurs de validation
400après la migration. Supprimeztemperature,top_pettop_k. Le serveur ignore les valeurs dans la plage autorisée, mais les valeurs hors plage renvoient une erreur400. - Les réponses s’arrêtent trop tôt.
max_output_tokensplafonne la réflexion et la sortie ensemble. Supprimez les anciens plafonds bas comme 8 192, ou relevez le plafond à 65 536. Pour une sortie plus longue, réglezbackgroundsurtrueetmax_output_tokensau-delà de 65 536 (par exemple 131 072 ou 262 144). Avecbackground: truemais sansmax_output_tokens, le serveur s’arrête après 65 536 tokens. Consultez le guide long decode de Google. MALFORMED_FUNCTION_CALL. Cela peut arriver lorsqu’un prompt système demande des appels d’outils en JSON brut sans outils déclarés. Déclarez les outils via l’appel de fonctions, ou utilisez les sorties structurées. Si votre code n’a besoin que d’un oui/non ou d’un score, notre prise en main de l’API Gemini Decisions propose une solution moins chère.429 RESOURCE_EXHAUSTED. Une cause documentée est la limite de dépenses. Attendez et réessayez, ou envoyez des contextes plus petits.- Les requêtes expirent. Selon Google, les prompts difficiles peuvent prendre plusieurs minutes. Utilisez l’exécution en arrière-plan, ou réglez les délais d’expiration de votre client HTTP sur au moins 15 minutes.
En résumé
Utilisez Neon quand Hydrogen ne suffit plus pour du code multifichier, de longs documents ou de l’analyse, et que vous n’avez pas besoin de la réflexion supplémentaire de Carbon. Commencez en high, testez medium, gardez xhigh pour les tâches les plus difficiles, et envoyez le travail non urgent via Batch ou Flex pour moitié prix. Pour simplement l’essayer, l’application Gemini avec un forfait Pro ou Ultra est le plus rapide, puisque l’API exige la facturation dès le premier appel. Hydrogen reste le point de départ gratuit, et Google l’a aussi intégré à Search, comme expliqué dans la mise à niveau de Google Search vers Gemini 4 Hydrogen. Retrouvez d’autres guides de ce type dans notre rubrique Guides IA.
Questions fréquentes
Gemini 4 Neon est-il gratuit ?
Pas dans l’API. La page des tarifs de Google indique chaque prix gratuit de Neon comme non disponible : il vous faut donc un projet AI Studio payant avec une facturation associée. Les abonnés Google AI Pro et Ultra peuvent sélectionner Neon dans l’application Gemini, et Hydrogen dispose toujours d’une offre gratuite.
Quel est l’ID de modèle de Gemini 4 Neon ?
L’ID de modèle est gemini-4-neon. La checklist de migration de Google indique que passer d’un autre modèle Gemini 4 ne nécessite aucune modification du schéma des requêtes au-delà de l’ID du modèle, du niveau de réflexion et d’un projet payant.
Gemini 4 Neon est-il moins cher que Gemini 4 Carbon ?
Pas par token jusqu’au 30 novembre 2026 : Carbon coûte alors 2,00 $ et 10,00 $ par million de tokens, contre 3,00 $ et 15,00 $ pour Neon. À partir du 1er décembre, Carbon passe à 4,00 $ et 20,00 $. Google affirme aussi que Neon a un coût par tâche inférieur de 32 % à celui de Carbon au niveau high.
Gemini 4 Neon prend-il en charge la mise en cache du contexte ?
Uniquement le cache implicite. Le cache explicite avec cachedContents et caches.create n’est pas pris en charge : supprimez donc les champs cached_content. Le cache implicite s’active sur les prompts d’au moins 4 096 tokens et réduit de 95 % le prix de l’entrée en cache, à 0,15 $ par million de tokens.
Quiz express
Quel est le niveau de réflexion par défaut de Gemini 4 Neon ?
- medium
- high
- xhigh
Neon utilise high par défaut et prend aussi en charge low, medium et xhigh ; il n’accepte pas minimal.
Combien coûte une exécution Neon de 200K tokens en entrée et 20K en sortie au niveau Batch ?
- $0.45
- $0.90
- $1.62
À 1,50 $ en entrée et 7,50 $ en sortie par million de tokens, cela fait 0,30 $ plus 0,15 $, soit 0,45 $.
Quel niveau de réflexion Neon refuse-t-il avec une erreur ?
- low
- xhigh
- minimal
Neon prend en charge low, medium, high et xhigh, et refuse minimal : utilisez donc low à la place.
Sources
Liens vérifiés pour la dernière fois le 20 novembre 2026.
- What’s new in Gemini 4 Neon (Google AI Studio docs)
- Gemini 4 Neon model page (Google AI Studio docs)
- Gemini API pricing (Google AI Studio docs)
- Choosing a model (Google AI Studio docs)
- Billing (Google AI Studio docs)
- Rate limits (Google AI Studio docs)
- Gemini 4 Neon model card (Google DeepMind)
- Introducing Gemini 4 Neon (Google blog, November 18, 2026)


Écrire une réponse