Google lanzó Gemini 4 Neon el 18 de noviembre de 2026: un modelo intermedio que Google sitúa entre Hydrogen y Carbon, con un coste por tarea menor que el de Carbon según la propia medición de Google, pero con un precio por token más alto que Carbon hasta el 30 de noviembre. Aquí verás dónde puedes usarlo, cómo hacer tu primera llamada a la API en Python, JavaScript o curl, qué nivel de pensamiento elegir, cuánto cuesta la ejecución de un agente y qué errores te encontrarás al migrar una app. Cada precio, límite y ejemplo de código sale de la documentación oficial de Google, revisada el 20 de noviembre de 2026.
Puntos clave
- Gemini 4 Neon se sitúa entre Hydrogen y Carbon y cuesta 3,00 $ de entrada y 15,00 $ de salida por cada millón de tokens.
- En la API, Neon solo está disponible en el nivel de pago; los suscriptores de Pro y Ultra pueden elegirlo en la app de Gemini.
- Usa por defecto el nivel de pensamiento high, añade xhigh y rechaza minimal; elige el nivel más bajo que supere tus pruebas.
- Hasta el 30 de noviembre, Carbon es más barato por token; a partir del 1 de diciembre, Carbon duplica su precio hasta 4,00 $ y 20,00 $.
Novedades: Gemini 4 Neon en un minuto
Neon (ID de modelo gemini-4-neon) es el nuevo modelo intermedio de Google dentro de la familia Gemini 4. Según la página What’s new in Gemini 4 Neon, «se sitúa entre Gemini 4 Hydrogen y Gemini 4 Carbon para tareas complejas de alta frecuencia», como refactorizaciones de varios archivos, documentos densos y flujos de trabajo científicos. La ficha del modelo indica que Neon está adaptado de Gemini 4 Carbon y que su fecha límite de conocimiento es marzo de 2026.
Lo básico, según la página del modelo Gemini 4 Neon:
- Entradas: texto, imagen, vídeo, audio y PDF. Salida: solo texto (sin generación de imágenes ni de audio, y sin Live API).
- Contexto: una única ventana unificada de 1.048.576 tokens compartida entre entrada, pensamiento y salida.
- Salida máxima: 65.536 tokens por respuesta síncrona por defecto, hasta 1.048.576 con long decode (decodificación larga).
- Herramientas: llamadas a funciones, salidas estructuradas, ejecución de código, uso del ordenador (computer use) y grounding con Search y Maps.
- Caché: solo caché implícita. La caché explícita no está disponible.
El anuncio de Google cita estos resultados (cifras de la propia Google): una puntuación de 61 en el Artificial Analysis Intelligence Index con el nivel de pensamiento xhigh (n.º 3 en la general), un 65,2 % en Terminal-Bench 4.1 y un 70,9 % en el Vals Index. La tabla de la propia ficha del modelo muestra a Claude Opus 5.5 ligeramente por delante en Terminal-Bench 4.1 (65,8 %). Google también afirma que, en el nivel high por defecto, Neon tiene «un coste por tarea un 32 % menor que Carbon». Es una afirmación por tarea, basada en usar menos tokens, no un precio por token más bajo.
En cifras
1.048.576tokens de ventana de contexto unificada
65.536tokens de salida máxima por defecto
3,00 $por cada millón de tokens de entrada
Dónde puedes usar Gemini 4 Neon
Según el anuncio de Google, Neon se está desplegando aquí:
| Dónde | Quién lo recibe | Cómo se elige |
|---|---|---|
| Gemini API (Google AI Studio) | Solo desarrolladores en el nivel de pago | model: "gemini-4-neon" |
| App de Gemini | Suscriptores de Google AI Pro y Ultra | Menú desplegable de modelos |
| Google AI Studio | Suscriptores de Google AI Pro y Ultra | No se especifica en el anuncio |
| Google Antigravity | Suscriptores de pago de Google AI Pro y Ultra | No se especifica en el anuncio |
| Gemini para empresas | Clientes empresariales | API o menú desplegable de modelos |
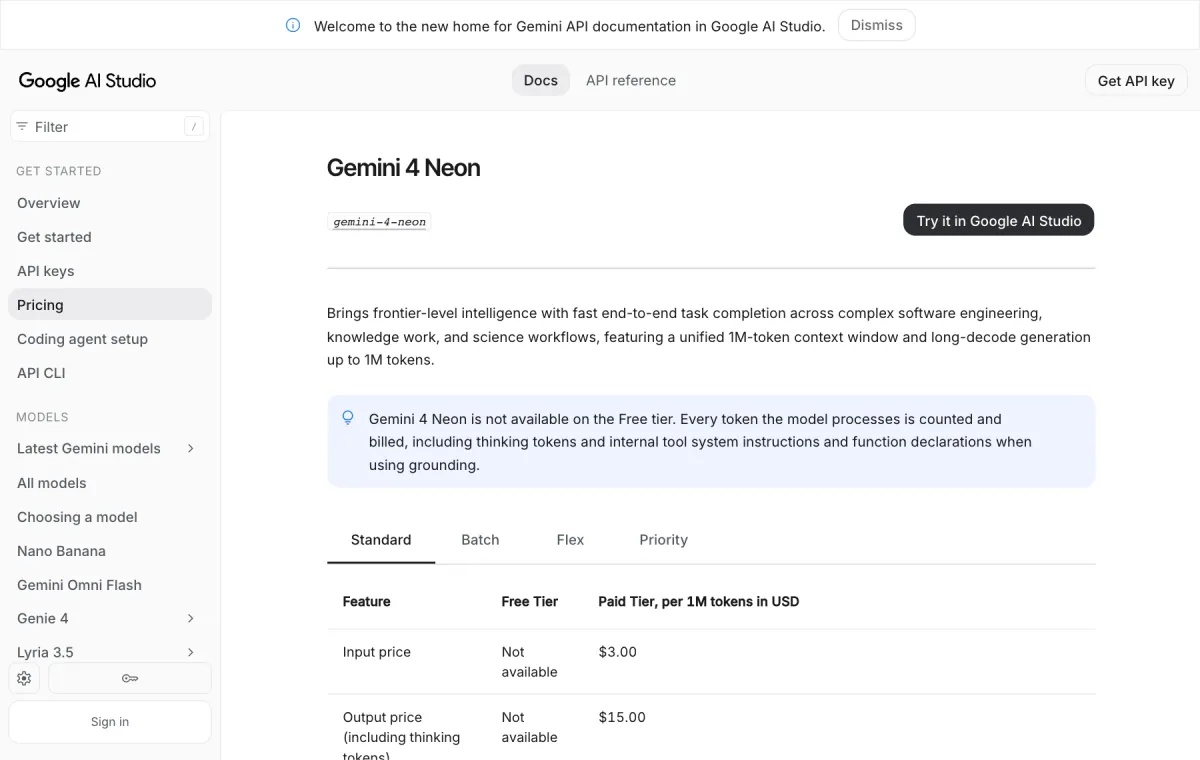
La API no tiene nivel gratuito para Neon: la página de precios marca todos los precios gratuitos de Neon como «Not available» (no disponible), igual que con Carbon. Hydrogen es el modelo de Gemini 4 que todavía puedes probar gratis. El anuncio de Google no enumera países, así que en EE. UU., el Reino Unido o el Golfo revisa el menú desplegable de modelos de la app de Gemini con un plan Pro o Ultra, o haz una llamada de prueba desde un proyecto de pago de AI Studio. Para saber cuánto cuestan esos planes en los Emiratos, consulta nuestra guía sobre planes de ChatGPT y Gemini y sus precios en AED en los Emiratos Árabes Unidos.
Qué necesitas
- Una cuenta de Google con acceso a Google AI Studio.
- Una cuenta de facturación de Google Cloud vinculada a tu proyecto de AI Studio. La guía de facturación de Google explica que pasar al nivel de pago implica vincular una cuenta de facturación y prepagar un mínimo de 5 $ en créditos con el plan Prepay (a algunas cuentas se les ofrece o asigna Postpay en su lugar).
- Python con
pip, o Node.js connpm, o simplementecurl.
Cómo configurar la API de Gemini 4 Neon, paso a paso
- Consigue una clave de API. Abre la página de claves de API de AI Studio. Google crea automáticamente un proyecto y una clave para los usuarios nuevos; si no, haz clic en Create API key (Crear clave de API) y sigue el cuadro de diálogo para añadir un par clave-proyecto.
- Activa la facturación en ese proyecto. En la misma página de claves de API (o en la página Projects), busca el proyecto y haz clic en Set up billing (Configurar facturación) en la columna Billing Tier. Si eres nuevo en la facturación, eliges un país, aceptas las condiciones y añades un método de pago; si ya tienes cuenta, eliges una cuenta de facturación. Después, prepaga el mínimo de 5 $ si te lo piden.
- Guarda la clave como variable de entorno. Los SDK leen
GEMINI_API_KEYautomáticamente. En macOS o Linux:
export GEMINI_API_KEY="YOUR_API_KEY"- Instala el SDK. Estas son las bibliotecas oficiales Google GenAI:
pip install -U google-genainpm install @google/genai- Envía tu primera solicitud con la Interactions API. En Python, según la documentación de Neon:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)

print(interaction.output_text)
La versión en JavaScript:
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

const interaction = await client.interactions.create({
  model: "gemini-4-neon",
  input: "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic.",
});

console.log(interaction.output_text);
Y la llamada REST con curl:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
}'- Vigila tu gasto. El uso aparece en AI Studio en Dashboard > Usage, y la guía de claves de API de Google recomienda configurar alertas de facturación en la consola de Google Cloud.
Cambiar desde otro modelo de Gemini 4 «no requiere cambios en el esquema de la solicitud» más allá del ID del modelo, el nivel de pensamiento y un proyecto de pago, según la lista de migración de Google. Nuestra guía de la API de Gemini 4 Hydrogen explica con más detalle la configuración común.

Niveles de pensamiento de Gemini 4 Neon: cuál usar
El nivel de pensamiento es tu principal palanca sobre calidad, latencia y coste. Neon admite low, medium, high (por defecto) y xhigh, pero no minimal, que usan Gemini 3.5 Flash-Lite y algunos modelos anteriores. La documentación de Google los describe así:
| Nivel | Uso de tokens | Ideal para |
|---|---|---|
low | Menos tokens, menor latencia | Chat rápido, procesamiento de alto volumen; sigue rindiendo bien en tareas agénticas |
medium | Menor uso de tokens, respuestas más rápidas | Programación interactiva, prototipado de interfaces en vivo, chat ágil, llamadas rápidas a herramientas |
high (por defecto) | Equilibrado | La mayoría de las tareas: programación compleja, agentes, llamadas a herramientas, trabajo de conocimiento multimodal |
xhigh | Más tokens, razonamiento más profundo | Ingeniería difícil de varios pasos, problemas analíticos y científicos en los que high se queda corto |
Se configura mediante generation_config. Este es el propio ejemplo de Google con xhigh en Python:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh"
    }
)

print(interaction.output_text)
En REST, el mismo campo va en el cuerpo JSON como "generation_config": {"thinking_level": "xhigh"}. El consejo de Google: ejecuta tus evaluaciones en los cuatro niveles con un max_output_tokens alto y luego elige el nivel más bajo que alcance tu listón de calidad. Los tokens de pensamiento se facturan como tokens de salida, así que bajar de high a medium suele ser una solución más barata que cambiar de modelo. La guía de pensamiento tiene más detalles.
¿Sabías que…?
En Neon, los tokens de pensamiento se facturan como tokens de salida, así que bajar del nivel de pensamiento high al medium suele ser una solución más barata que pasarse a un modelo más pequeño.
Neon vs. Hydrogen vs. Carbon: tabla de precios y cuándo elegir cada uno
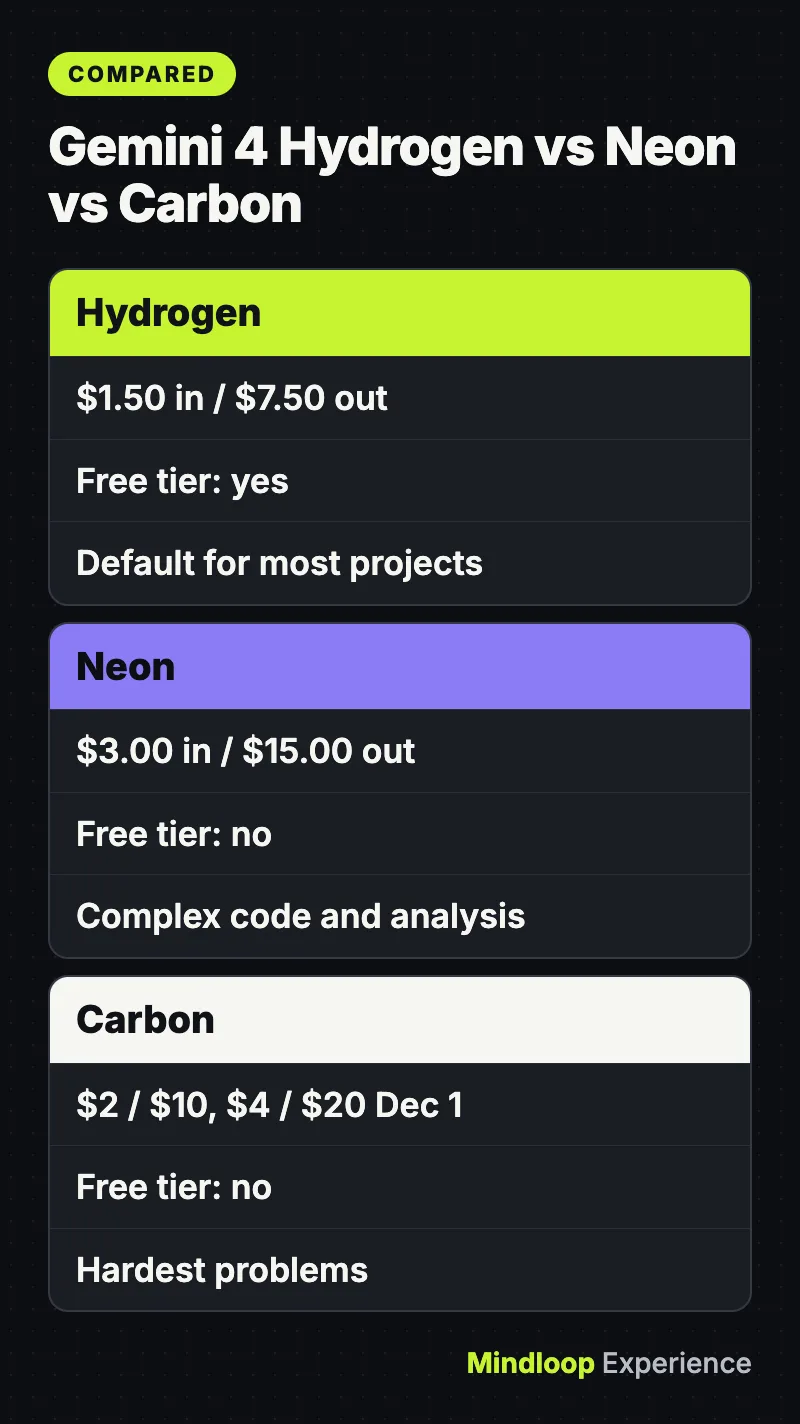
Precios estándar del nivel de pago por cada millón de tokens, según la página de precios de Google a 20 de noviembre de 2026. Los precios de salida incluyen los tokens de pensamiento.
| Modelo | Entrada | Salida | Entrada en caché | Batch / Flex (entrada / salida) | Nivel gratuito |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Sí |
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | No |
| Gemini 4 Carbon, hasta el 30 de nov. de 2026 | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | No |
| Gemini 4 Carbon, desde el 1 de dic. de 2026 | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | No |
Gemini 4 Argon tiene los mismos precios que Carbon. El nivel Priority de Neon cuesta 5,40 $ de entrada y 27,00 $ de salida. El precio de Neon es fijo en toda la ventana de 1M, y la página Choosing a model de Google señala que «Neon no tiene precio introductorio». Así que hasta el 30 de noviembre Carbon es más barato por token; a partir del 1 de diciembre, Carbon duplica su precio y Neon pasa a ser el más barato de los dos.
Las propias recomendaciones de Google para elegir:
- Hydrogen: la opción por defecto para la mayoría de los proyectos nuevos, la programación del día a día y los agentes trabajadores en paralelo, a la mitad del precio de Neon.
- Neon: ingeniería de software compleja, trabajo de conocimiento denso y flujos científicos «en los que Hydrogen no basta y no necesitas la verificación extra de Carbon». Google también lo indica como la actualización de
gemini-3.1-pro-preview. - Carbon: tus problemas más difíciles, como arquitectura de sistemas, demostraciones formales y auditorías de seguridad, con más tokens de pensamiento por turno. Consulta nuestro artículo sobre Gemini 4 Carbon liderando MathArena.
Los tres comparten el mismo esquema de solicitud, así que puedes pasar previous_interaction_id para entregar una conversación de un modelo a otro, por ejemplo Carbon para planificar e Hydrogen para escribir el código.
Ejemplo de coste: una ejecución de agente en high frente a Batch
Supón que la ejecución de un agente envía 200.000 tokens de entrada (un repositorio de código más instrucciones) y recibe 20.000 tokens de salida, contando el pensamiento. A precios de lista de Google (el número real de tokens depende de la tarea y del nivel de pensamiento):
- Neon, Standard: 0,2M × 3,00 $ = 0,60 $ de entrada, más 0,02M × 15,00 $ = 0,30 $ de salida. Total: 0,90 $.
- Neon, Batch o Flex: 0,2M × 1,50 $ = 0,30 $, más 0,02M × 7,50 $ = 0,15 $. Total: 0,45 $.
- Neon, Priority: 0,2M × 5,40 $ = 1,08 $, más 0,02M × 27,00 $ = 0,54 $. Total: 1,62 $.
- Neon, Standard, con 150.000 de los tokens de entrada en la caché implícita: 0,15M × 0,15 $ = 0,0225 $, más 0,05M × 3,00 $ = 0,15 $, más 0,30 $ de salida. Total: unos 0,47 $.
- Hydrogen, Standard: 0,30 $ + 0,15 $ = 0,45 $.
- Carbon, Standard: 0,40 $ + 0,20 $ = 0,60 $ hasta el 30 de noviembre, o 0,80 $ + 0,40 $ = 1,20 $ a partir del 1 de diciembre.
Con 1.000 ejecuciones, son 900 $ para Neon en Standard frente a 450 $ en Batch. La caché implícita se activa en prompts de al menos 4.096 tokens y descuenta un 95 % de la entrada en caché, así que coloca primero las instrucciones compartidas, las definiciones de herramientas y los archivos de referencia. Un modelo que necesita menos tokens para la misma tarea (lo que Google afirma de Neon frente a Carbon) cuesta menos por tarea terminada de lo que muestran estas cuentas.
Las cuentas de pago nuevas también tienen límites de gasto. La página de límites de frecuencia indica un límite de gasto de 10 $ cada 10 minutos para el Tier 1 (si se aplica depende de tu cuenta), lo que equivale a unas 11 de las ejecuciones Standard anteriores. La guía de facturación fija un tope mensual de 250 $ para el Tier 1.
¿Sabías que…?
La caché implícita funciona automáticamente en prompts de al menos 4.096 tokens y descuenta un 95 % de la entrada en caché, lo que deja la entrada en caché de Neon en 0,15 $ por millón de tokens.
Errores comunes y cómo solucionarlos
- Neon no funciona con tu clave del nivel gratuito. No se ofrece en el nivel gratuito. Haz clic en Set up billing en la página de claves de API o en la de proyectos. Si el proyecto muestra «Set up Prepay» o «No credits», termina la configuración de Prepay o añade créditos. La guía de facturación dice que la API solo atiende solicitudes del nivel de pago mientras tu saldo Prepay sea positivo.
- Falla
thinking_level: "minimal". Neon rechazaminimalcon un error. Usalowen su lugar. - El código de caché explícita deja de funcionar. Neon no admite caché explícita (
cachedContentsycaches.create). Elimina los camposcached_contenty confía en la caché implícita. - Errores de validación
400tras migrar. Eliminatemperature,top_pytop_k. El servidor ignora los valores dentro de rango, pero los valores fuera de rango devuelven un error400. - Las respuestas se cortan antes de tiempo.
max_output_tokenslimita el pensamiento y la salida en conjunto. Quita los topes bajos antiguos, como 8.192, o sube el límite a 65.536. Para salidas más largas, ponbackgroundentrueymax_output_tokenspor encima de 65.536 (por ejemplo, 131.072 o 262.144). Conbackground: truepero sinmax_output_tokens, el servidor se detiene tras 65.536 tokens. Consulta la guía de long decode de Google. MALFORMED_FUNCTION_CALL. Puede ocurrir cuando un prompt de sistema pide llamadas a herramientas en JSON sin formato y sin herramientas declaradas. Declara las herramientas con llamadas a funciones o usa salidas estructuradas. Si tu código solo necesita un sí/no o una puntuación, nuestra guía rápida de la Gemini Decisions API muestra una vía más barata.429 RESOURCE_EXHAUSTED. Una de las causas documentadas es el límite de gasto por frecuencia. Espera y vuelve a intentarlo, o envía contextos más pequeños.- Las solicitudes agotan el tiempo de espera. Google dice que los prompts difíciles pueden tardar varios minutos. Usa la ejecución en segundo plano o configura los tiempos de espera de tu cliente HTTP en al menos 15 minutos.
Conclusión
Usa Neon cuando Hydrogen se quede corto con código de varios archivos, documentos largos o análisis y no necesites el pensamiento extra de Carbon. Empieza en high, prueba medium, reserva xhigh para los trabajos más difíciles y envía lo que no sea urgente por Batch o Flex a mitad de precio. Si solo quieres probarlo, lo más rápido es la app de Gemini con un plan Pro o Ultra, ya que la API exige facturación desde la primera llamada. Hydrogen sigue siendo el punto de partida gratuito, y Google también lo ha llevado a la Búsqueda, como contamos en la actualización de Google Search con Gemini 4 Hydrogen. Tienes más guías como esta en nuestra sección Guías de IA.
Preguntas frecuentes
¿Gemini 4 Neon es gratis?
No en la API. La página de precios de Google indica que ningún precio del nivel gratuito de Neon está disponible, así que necesitas un proyecto de pago de AI Studio con la facturación vinculada. Los suscriptores de Google AI Pro y Ultra pueden seleccionar Neon en la app de Gemini, e Hydrogen sigue teniendo nivel gratuito.
¿Cuál es el ID de modelo de Gemini 4 Neon?
El ID de modelo es gemini-4-neon. La lista de migración de Google indica que cambiar desde otro modelo de Gemini 4 no requiere cambios en el esquema de la solicitud más allá del ID del modelo, el nivel de pensamiento y un proyecto de pago.
¿Gemini 4 Neon es más barato que Gemini 4 Carbon?
No por token hasta el 30 de noviembre de 2026: en ese periodo Carbon cuesta 2,00 $ y 10,00 $ por millón de tokens, frente a los 3,00 $ y 15,00 $ de Neon. A partir del 1 de diciembre, Carbon sube a 4,00 $ y 20,00 $. Google también afirma que Neon tiene un coste por tarea un 32 % menor que Carbon en high.
¿Gemini 4 Neon admite caché de contexto?
Solo caché implícita. La caché explícita con cachedContents y caches.create no está disponible, así que elimina los campos cached_content. La caché implícita funciona en prompts de al menos 4.096 tokens y descuenta un 95 % de la entrada en caché, hasta 0,15 $ por millón de tokens.
Test rápido
¿Cuál es el nivel de pensamiento por defecto de Gemini 4 Neon?
- medium
- high
- xhigh
Neon usa high por defecto y también admite low, medium y xhigh; no acepta minimal.
¿Cuánto cuesta en el nivel Batch una ejecución de Neon con 200K tokens de entrada y 20K de salida?
- $0.45
- $0.90
- $1.62
A 1,50 $ de entrada y 7,50 $ de salida por millón de tokens, son 0,30 $ más 0,15 $, es decir, 0,45 $.
¿Qué nivel de pensamiento rechaza Neon con un error?
- low
- xhigh
- minimal
Neon admite low, medium, high y xhigh, y rechaza minimal, así que usa low en su lugar.
Fuentes
Enlaces revisados por última vez el 20 de noviembre de 2026.
- What’s new in Gemini 4 Neon (Google AI Studio docs)
- Gemini 4 Neon model page (Google AI Studio docs)
- Gemini API pricing (Google AI Studio docs)
- Choosing a model (Google AI Studio docs)
- Billing (Google AI Studio docs)
- Rate limits (Google AI Studio docs)
- Gemini 4 Neon model card (Google DeepMind)
- Introducing Gemini 4 Neon (Google blog, November 18, 2026)


Escribe una respuesta